벤치마킹: 인공지능을 평가하기 위한 경쟁
AI가 정말 '생각'을 하는 걸까, 아니면 데이터를 그냥 게워내는 것뿐일까? 속아 넘어가지 않고 디지털 정신을 평가하는 과학.

AI가 정말 '생각'을 하는 걸까, 아니면 데이터를 그냥 게워내는 것뿐일까? 속아 넘어가지 않고 디지털 정신을 평가하는 과학.

나에게 고정점 하나를 달라. 그러면 세상을 움직여 보이겠다. - 아르키메데스
인공지능 개발 전반의 한복판에는 군비 경쟁이 자리하고 있지만, 여기서는 특히 언어에 적용되는 인공지능에 초점을 맞추려 한다. AI 시스템을 개발한다는 건 일련의 능력, 원칙적으로는 인지적이고 인간적이거나 인간에게 쓸모 있는 능력에 도달하려는 일이다. 글쓰기, 이해, 번역, 요약, 예의 바르게 굴기, 공정하게 굴기, 정보 보고서 작성하기, 우리는 언제나 유라시아와 전쟁 중이었다고 선언하기, 속이기, 반대파 뒷조사하기, 열핵전쟁에서 이기기 등등. 이런 작업 중 무엇이든, 시스템이 그걸 잘하는지 못하는지, 특히 같은 목적으로 설계된 다른 시스템과 비교해 어떤지 평가할 방법이 있어야 한다.
이건 모델을 설계하는 (혹은 재배하는) 사람들에게도, 모델을 계약하거나 쓰려는 사람들에게도 걸린 문제다. 인공지능 시스템을 만드는 사람들은 겨냥할 측정 가능한 목표가 필요하고, 모델을 계약하거나 써볼까 고민하는 사람들은 어느 게 제일 나은지 알고 싶어 한다. 그런데 그걸 어떻게 하나? 음, 한 가지 방법은 바이브로 하는 건데, 이건 누구나 언어 모델을 쓸 때 하는 짓의 세련된 버전이다. 써보고, 이건 못 풀겠지 싶은 문제를 던졌는데, 그걸 풀어버리고, 턱이 빠지고, "와, 이거 미쳤다" 하는 거다. 그런데 많은 사람이 깨달았듯, 그건 운일 수도 있고, 하필 그 모델이 훈련받은 바로 그 유형의 문제일 수도 있으며, 그걸 잘했다고 해서 다른 것도 잘한다는 보장은 없다.
인공지능 시스템을 만드는 사람들은 겨냥할 측정 가능한 목표가 필요하고, 모델을 계약하거나 써볼까 고민하는 사람들은 어느 게 제일 나은지 알고 싶어 한다. 그런데 그걸 어떻게 하나?
언어 모델의 성능을 평가하는 좀 더 세련된 방법은 전문가들을 데려다 모델의 능력/지식을 직접 평가하게 하는 것이다. 이게 조금 더 낫긴 하지만 훨씬 비싸고 느리며 여전히 틀릴 수 있다. 또 다른 방법은 모델들끼리 바이브로, 서로 겨루게 하는 것이다(chatbot arena에서 ELO 랭킹으로 하는 것처럼). 어떤 모델인지 알려주지 않은 채 두 모델을 주고, 어느 쪽이 더 마음에 드는지 고르는 식이다. 하지만 이것도 눈대중 평가와 기본적으로 같은 문제를 안고 있다. 한낱 의견에 기대고 있다는 것. 꽤 많은 걸 알려주지만 충분하진 않다. 네 번째 방법은 모델 하나를 놓고 뇌를 해부하듯 반으로 갈라서 무슨 일이 일어나는지 보는 것이다. 이른바 '화이트박스' 분석(블랙박스의 반대, 즉 안에 뭐가 들었는지 들여다볼 수 있는 상자)인데, 어떤 모델에 대해선 별로 알려주는 게 없거나, 아니면 너무 느리고 비현실적이다. 게다가 OpenAI도 Anthropic도 자기네 황금 토큰을 낳는 거위를 들여다보게 해줄 리 없다. 남은 건 표준화된 시험을 치르게 하는 것이다.
'벤치마크'라는 단어에는 여러 뜻이 있고, 무슨 '시험대' 같은 걸 말하는 것처럼 들리지만, 어원은 그게 아니다. 어원이 늘 중요한 건 아니지만 이번엔 문제를 이해하는 데 도움이 될 수 있다. 영어 'benchmark'는 측지학에서 왔다. 측지학은 땅을 측정하는 학문으로, 지형 측량사와 토지 측량사가 쓰는 자료를 만들어낸다. 도시에는 높낮이가 제각각이라 여러 건물의 상대적 고도를 고려해야 한다. 예컨대 도시에서 물이 어디로 흘러내리는지 감안해 배관 경로 같은 걸 짤 때 말이다.
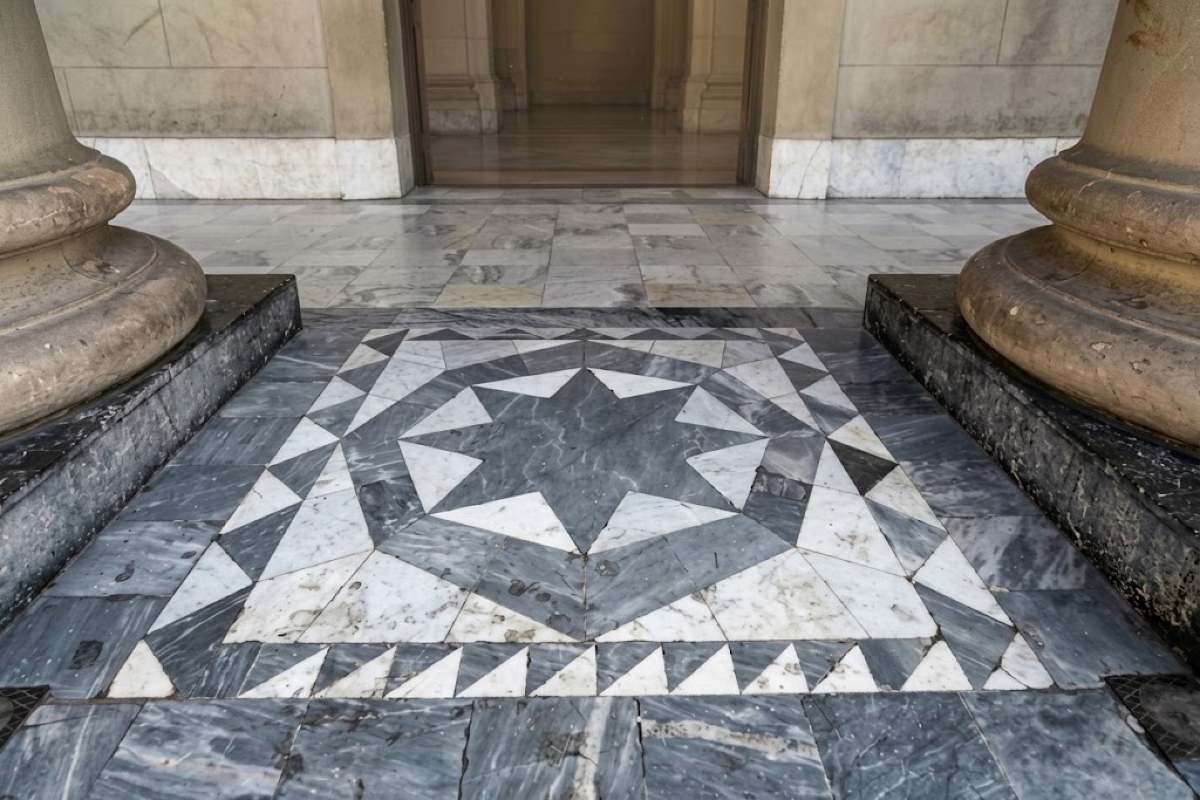
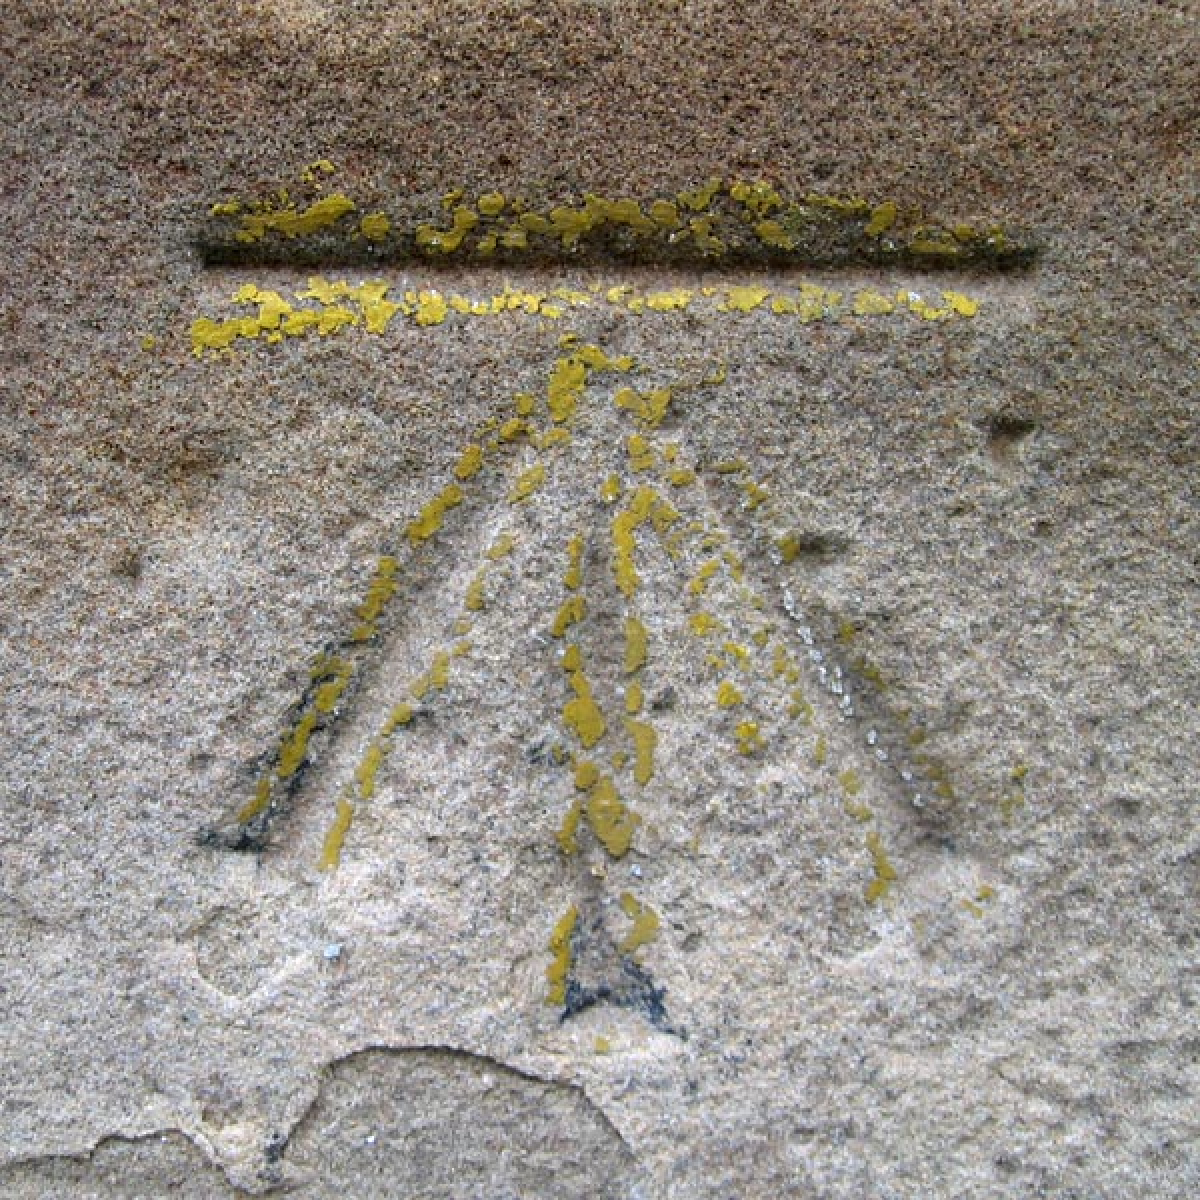
이를 위해 근대 도시의 당국은(여기서 근대란 대략 18세기 이후를 말한다) 도시 곳곳에 측지 '고정점'(스페인어에서는 측지 benchmark를 이렇게 부른다)을 표시해 두었다. 도시마다 기준이 되는 고정점, 즉 원점이 있는데, 부에노스아이레스 자치시에서는 대성당 입구에 있다. 바람장미 모양이다. 수도의 모든 측지 고정점은 이 원점을 기준으로 한 상대 고도로 표시되어 있다.
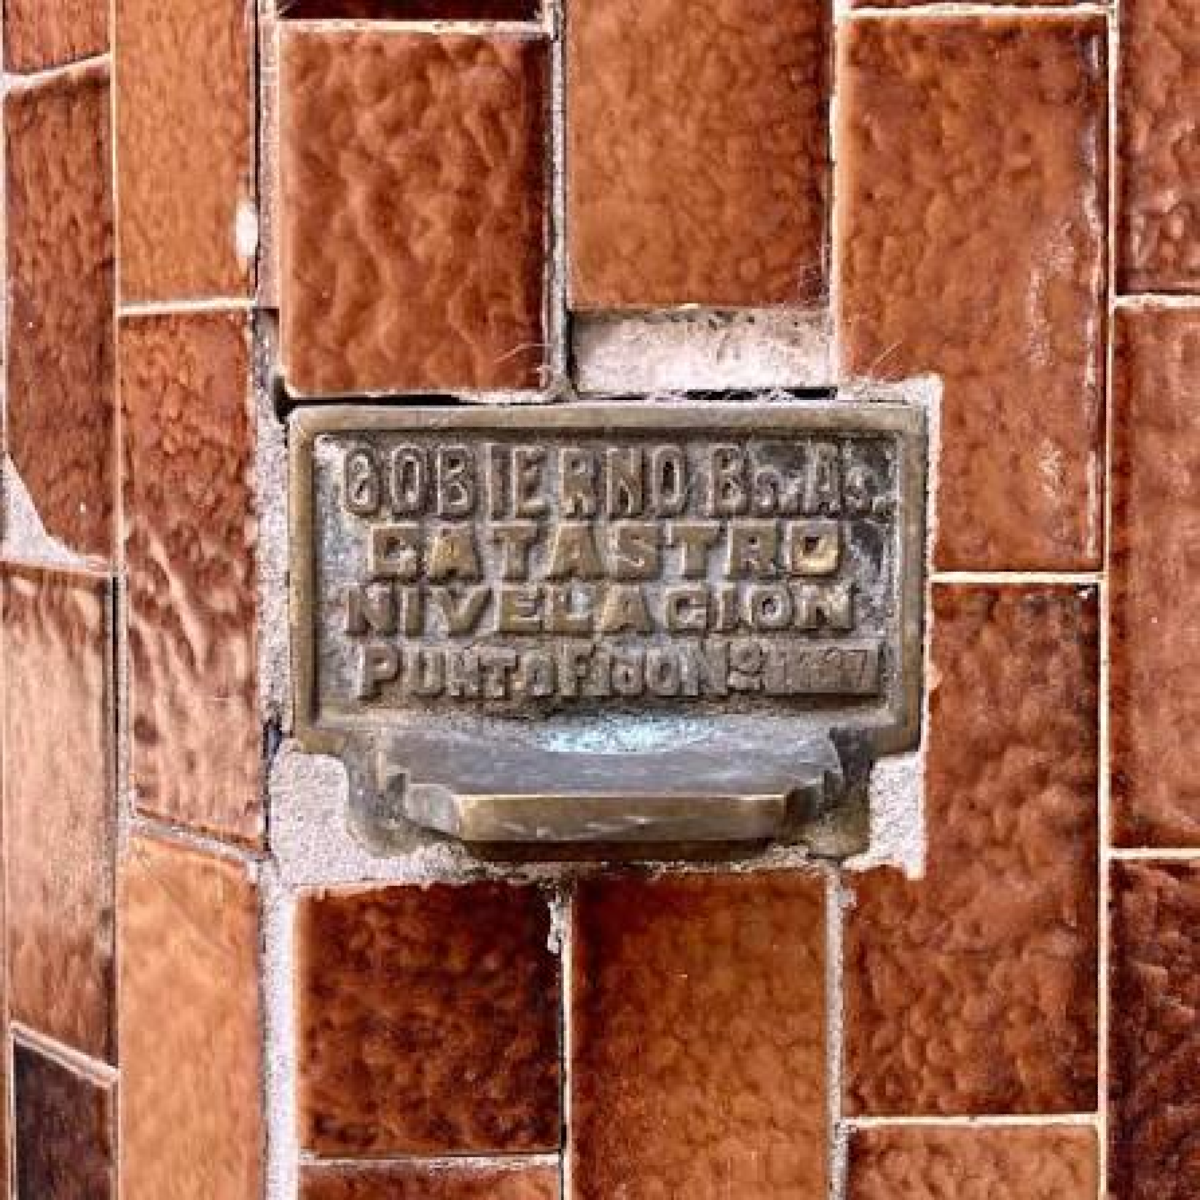
도시의 기준 고정점, 대성당에 있는 그것은 이렇게 생겼다:
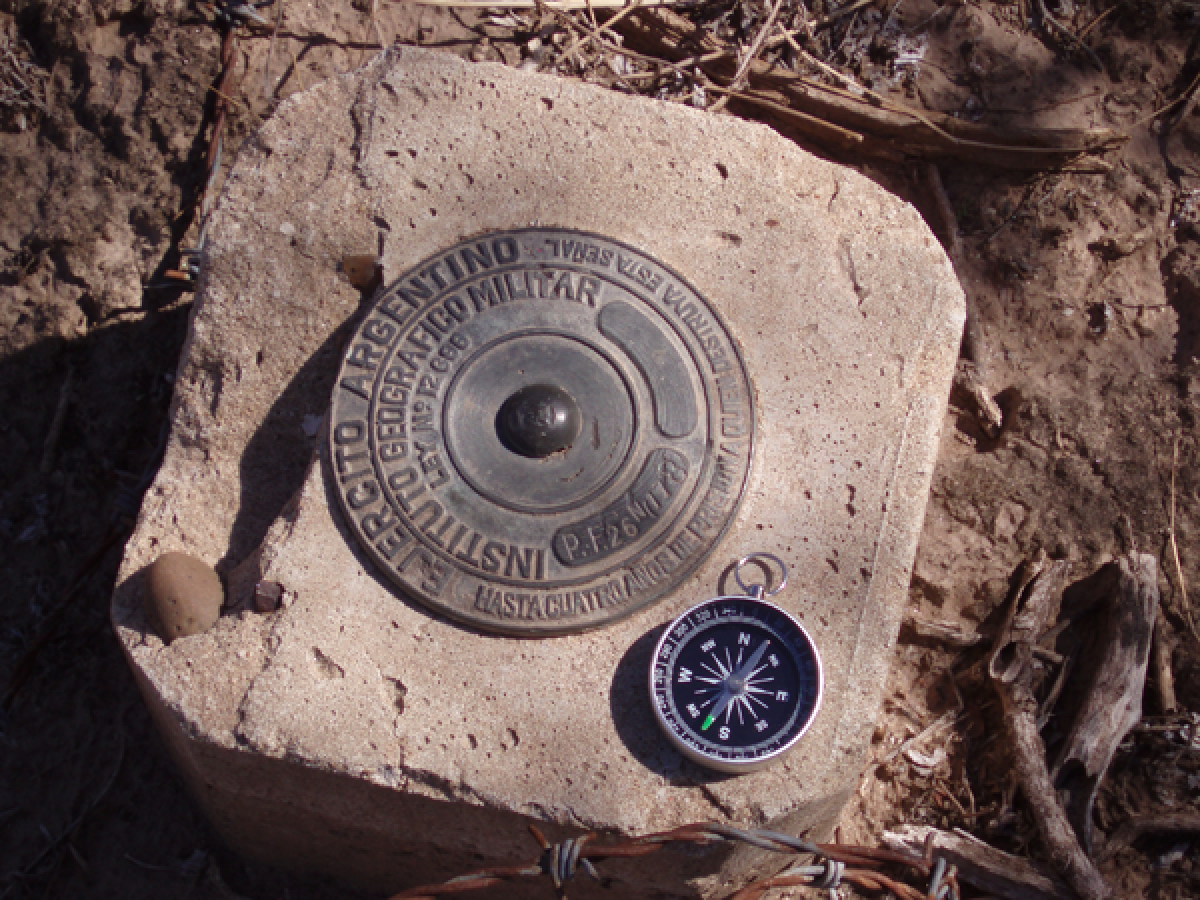
하지만 국립지리원(군 지리원의 후신)이 설치한 고정점은 전국에 있다:
덕분에 토지 측량사, 지형 측량사, 지도 제작자, 건축가, 토목 기술자들은 고도와 지리적 위치가 매핑된 상대적 기준점을 작업에 쓸 수 있다. 요즘은 이 중 상당 부분을 GPS로 하지만, 이런 핵심 정보를 전적으로 위성 시스템에 맡길 만큼 멍청한 나라는 (적어도 아직은) 없다. 벽에 박힌 쇳조각과 산더미 같은 대장만 한 게 없다(Ruocco라면 low tech, high life라고 했을 거다).
'벤치마킹'의 원래 용법(돌이나 화강암에 수평 표시[mark]를 새겨 거기에 수준기를 대고, 수준 측량용 막대를 올려놓을 벤치, 즉 받침["bench"]을 만드는 것)을 확장해서, 여러 분야에서 이 용어를 같은 종류의 여러 대상을 비교하는 (상대적) 성능 시험이라는 뜻으로 쓴다. 컴퓨팅에서는 우리 게이머들이 특정 게임이나 기준 테스트로 시스템 성능을 돌려보는 데 쓰는데, 그러면 내 기계가 다른 기계에 비해 얼마나 좋은지 대략 감이 온다.
머신러닝 시스템에서 흔한 관행은 모델을 훈련시킬 데이터셋(데이터의 집합)을 두고, 이를 훈련용 80%와 평가용 20%로 나누는 것이다. 80%로 훈련한 모델이 평가용 데이터를 한 번도 보지 않고도 평가용 데이터를 잘 예측한다면, 그 모델은 훈련 데이터에서 본 것을 바탕으로 일반화했고, 어떤 의미에서 '학습'했다고 말할 수 있다. 그렇지 않다면 아니다. 이미 본 문제만 풀 수 있는 모델은 아무짝에도 쓸모가 없다.
실제로는 이렇게 생각하면 된다. 훈련 데이터셋에는 지리, 대수, 해석학 문제가 잔뜩 있고, 거기에 선택지 몇 개와 정답이 딸려 있다(문법 문제일 수도 있고, 매직 카드에 관한 지식 문제일 수도 있다). 평가 데이터셋에는 훈련에서 나오지 않은 문제들이 있고, 정답은 모델에게 보여주지 않고 평가용으로 따로 챙겨둔다. 모델에게 선택지 몇 개를 주고(객관식 시험처럼) 맞히는지 본다. 정답 비율이 그 데이터셋에서의 정밀도, 즉 accuracy가 되고, 이걸 벤치마크로 삼을 수 있다.
이런 의미에서, 여러 언어 모델에 치르게 할 수 있는 평가용 데이터셋은(훈련 데이터셋의 일부이든 아니든) 벤치마크의 역할을 한다.
그런데 그래픽 벤치마크에서 내 기계가 몇 점 받았는지는 그 자체로 중요한 게 아니라, 게임을 하든 영상을 렌더링하든 뭘 하든(그건 벤치마크가 아니다) 내 기계로 실제로 뭘 할 수 있는지 보여주는 단서로서 중요하다. 언어 모델도 비슷하다. 언어 모델이 벤치마크 에서 잘하는 게 그 자체로 뭔가를 뜻해서 중요한 게 아니다. 잘한다는 사실이 벤치마크가 아닌 일에서 그 모델이 뭘 할 수 있는지 알려줄 때에만 잘하는 게 중요하다.
언어 모델이 벤치마크에서 잘하는 게 그 자체로 뭔가를 뜻해서 중요한 게 아니다. 잘한다는 사실이 벤치마크가 아닌 일에서 그 모델이 뭘 할 수 있는지 알려줄 때에만 잘하는 게 중요하다.
이건 우리 교사들이 시험을 치르게 할 때 하는 일과 아주 비슷하다. 평가 도구는 그 자체로는 중요하지 않다. 많은 중고등학생(과 많은 대학생)이 가끔 교사가 내준 과제나 자기가 쓰는 에세이가 교사가 읽으면서 뭔가 얻는 의뢰물이라도 되는 듯, 마치 교사가 뭔가를 배우기라도 할 것처럼 (잘못) 생각하고 행동한다. 과제가 무슨 기업이 컨설팅 회사에 맡기는 보고서라도 되는 것처럼. 우리 교사들이 학생에게서 배울 수 없다는 말은 아니다(늘 배운다). 하지만 그게 학생들에게 평가를 치르게 하는 이유는 아니다.
평가의 역할 중 하나는 진단이다(다른 역할도 있다. 예컨대 형성적 역할: 네가 머리를 쥐어짜면서 목표 능력을 차근차근 벼려가길 바라는 것). 네가 지금 어디쯤 와 있는지 알아서, 나중에 직업 생활에서 비슷한 문제를 풀 때 어떨지 대략 짐작하고 싶은 것이다(대학 수준이라면 그렇다). 다시 말해 사람에게 치르는 시험은 많은 경우, 어떤 사람에게 비슷한 문제를 풀어내는 성향으로서의 역량을 귀속시킬 근거를 얻기 위한 도구다. 누군가를 알게 됐는데 그 사람이 여러 번 거짓말하는 걸 보고, 그걸 그 사람에게 거짓말쟁이라는 속성을 붙일 충분한 이유로 삼는 것의 세련된 친척쯤 된다. 거짓말쟁이로 찍히는 건 위험하다(양치기 소년 이야기처럼). 사람들이 네가 앞으로도 거짓말할 것처럼 대하고, 그렇게 대하면 더는 너를 진지하게 받아주지 않기 때문이다(일종의 특수한 사회적 죽음이다). 반면 변호사로 인정받는다는 건 네가 학과의 모든 교수를 상대로 한 판씩 이겼다는 뜻이고(지우가 포켓몬 마스터들을 꺾듯이), 앞으로도 계속 그럴 수 있으리라 여겨진다는 뜻이다.
자, 운전면허 시험이 단순한 허가가 아니라 역량의 귀속과 거기 따라붙는 책임에 기반한 허가이듯(운전을 잘할 능력이 있다면, 운전을 못한 데 대한 책임도 너에게 있다), 더 추상적인 역량에서도 마찬가지다. 예를 들어 인지 능력 같은 것. 심리측정학자들은 오래전부터 더 추상적인 역량을 평가할 방법을 설계하려 애써왔는데, 거기에는 역량 중의 역량, 인간 능력 허가증의 성배라 할 바로 그 역량, 즉 지능도 포함된다.
인공지능 전문가 François Chollet(ARC-AGI 벤치마크의 창시자)의 말을 빌리면, 어떤 과제를 해결하는 능력은 네가 얼마나 숙련됐는지를 말해주고, 지능은 새로운 과제를 해결할 새로운 능력을 얼마나 효율적으로(이를테면 빨리) 습득하는지를 잰다. 즉 누군가가 똑똑하다고 할 때 우리는 그 사람이 특정한 뭔가를 할 수 있다고 말하는 게 아니라, 그럴 마음과 기회와 시간이 있다면 그 능력에 능숙해지는 데 다른 사람보다 시간이나 노력이 덜 들 거라고 말하는 것뿐이다(그래서 본인이 보기에든 남이 보기에든 아무짝에도 쓸모없는 똑똑한 사람이 그렇게 많다는 사실과 아귀가 맞는 것이다).
그러니 지능은 직접 측정할 수 없다. 당신의 역량 중 상당 부분은 심리측정학자들이 '결정성 지능'(또는 결정성 g 요인, Gc)이라 부르는 것일 수 있고, 이는 '유동성 지능'(또는 Gf)과 구분되기 때문이다. 인지 능력 측정을 전문으로 하는 심리학자들은 결정성 지능에 별 관심이 없다. 어떤 것에 대해 많이 알면서도 바보일 수 있기 때문이다(이건 그 사람들 얘기니까 나한테 뭐라 하지 마시길). 'idiot savant'(바보 천재)란 데이터는 기억하지만 외운 데이터 너머로는 추론하지 못하는 인물을 말한다. 이걸 가장 잘 보여주는 건 아마 보르헤스의 「기억의 천재 푸네스」일 것이다.
이 테스트들은 당신의 지능을 직접 측정하는 게 아니다(그런 건 가능해 보이지도 않는다). 당신의 결과가 어떤 연령별 평균 결과와 비슷한지를 측정할 뿐이다. 실제 나이보다 많은 연령대와 비슷한 점수가 나온다면, 당신이 또래보다 인지 능력을 갖추는 데 더 효율적이라는 뜻이 된다. 점수가 더 높은 연령대의 평균과 일치할수록 지수도 올라간다: (정신연령/실제연령)*100 = IQ.
IQ 높다고 으스대는 스무 살들에게 경고 한마디: 그건 운이 아주 좋아 봐야 서른 살 평균 점수를 받는다는 뜻이다(정신연령 36세인 18세라면 IQ 200, 측정 가능한 한계치다. IQ 130이면 18세가 24세처럼 IQ 시험을 치른다는 얘기고...). 그러니까 너희가 그렇게 까대는 바로 그 아저씨들 수준이라는 거다. 남자가 서른에 IQ가 높다는 건 그저 마흔이 되기 전에 내 인생 뭐 하고 있나 고뇌하고, 애인한테 차이고, 할리 데이비슨을 사게 된다는(아니면 금수저가 아닌 경우 GTA VI 하려고 플레이스테이션을 사게 된다는) 뜻일 뿐이다. 축하한다!
오직 죽은 자만이 이 멍청한 세대 간 전쟁의 끝을 보았다. IQ(에 관한 담론)는 그 전장 중 하나일 뿐이다. 어쨌든 뉴턴과 같은 IQ를 가졌다는 게 근사하게 들리는 유일한 이유는(행운을 빈다) 뉴턴이 자기 인생으로 뭔가 흥미로운 일을 했기 때문이라는 걸 기억하자. 나라면 그쪽에 집중하겠다.
LLM에 대해서도 같은 질문을 던질 수 있다. 이것들은 똑똑한 걸까, 아니면 데이터를 외운 걸까? 예컨대 테드 창(그 유명한 SF 작가)은 LLM이 그저 일종의 데이터 압축(.zip이나 .rar 같은)일 뿐이라고 말한다. 그것도 손실 압축(lossy compression) 말이다. 그는 LLM을 인터넷의 흐릿한 .jpeg에 비유했다. 그렇다면 인류가 디지털화한 모든 글을 통째로 갈아 마신 언어 모델이 그저 게워내는 게 아니라 진정한 이해에 도달할 수 있다고 주장하려면, 우리는 그것을 어떻게 평가해야 할까? 이게 바로 수천조 달러짜리 질문이고, 그 벤치마크는 바로 우리다.
범용 인공지능은 우리의 자연적 일반 지능에 대응하는 개념이다. 그러니 이런 생각들을 언어 모델에 적용해 보려면, 우리가 어떻게 스스로 지능이 있다고 주장할 수 있는지, 우리가 무엇을 할 수 있는지, 실제로 무엇 때문에 서로에게 지능이 있다고 여기는지를 따져봐야 한다. 어떤 인지 과제에서든 전반적으로 좋은 성과를 예측하는 평가를 설계할 수 있다면, 그 모델이 지능적이라고 믿을 근거가 생길 것이다. 즉 '일반 지능'이라는 이론적 구성 개념, 다시 말해 우리가 지능이라고 생각하는 것의 모델을 설계하고, 언어 모델의 벤치마크로 쓸 과제(시험)를 만들어야 한다는 뜻이다. LLM이 그걸 풀어낸다면, 우리가 평가한다고 가정하는 그것(이론적 구성 개념)을 LLM이 갖고 있다고 말할 진짜 근거가 되는 그런 과제 말이다. "이걸 풀 수 있다면 내 재산 관리를 맡기겠다"(미국이나 중국이라면 핵무기를 맡기겠다) 싶은 종류의 것들.
인류가 디지털화한 모든 글을 통째로 갈아 마신 언어 모델이 그저 게워내는 게 아니라고 주장하려면, 우리는 그것을 어떻게 평가해야 할까? 이게 바로 수천조 달러짜리 질문이고, 그 벤치마크는 바로 우리다.
하지만 그렇게 쉽지 않다. 오늘날 언어 모델 설계에는 어떤 연구 방향을 좇을지 판단하기 위한 벤치마크가 필요하다. 새로운 아키텍처가 이전 것보다 더 나은지 알 수 없다면, 새 언어 모델 아키텍처를 고안해 봐야 기댈 데가 별로 없다. 더 나아 보이는 것만으로는 부족하다. 설상가상으로, 공개된 벤치마크는 다음 모델들의 학습 데이터에 들어가리라고 봐야 하니, 그 벤치마크를 풀었다는 게 알려주는 정보는 제한적이다. 벤치마크를 공개하고 나면(반복 가능하고 공정해야 하는데, 그러는 한 방법이 공개하는 것이다) Anthropic이나 알리바바 사람들이 그 벤치마크로 모델을 훈련시킬 수 있다. 그러면 모델은 벤치마크에서는 탁월해지지만, 정작 그 벤치마크가 측정하려던 능력에서 뛰어나다는 보장은 없다.
업계도 대중도 더 나은 평가가 필요하지만, 이건 생색도 안 나고 돈도 많이 들고 어려운 일이다. 믿어 달라. 우리가 시험을 치르게 할 때 선생을 좋아하는 사람은 아무도 없고, 언어 모델 평가도 크게 다르지 않다. 이 기계들을 평가하는 것보다 설계하는 쪽에 훨씬 더 많은 돈이 몰린다. 그리고 이건 우리가 기준점을 갖고 있는 것, 즉 사람에게서든 기계에서든 제대로 측정할 줄은 모르더라도 우리 자신의 능력에 관한 문제일 뿐이다. 진짜 큰 질문은 이거다. 실리콘밸리가 말하는 '기계 속의 신'을 위한 벤치마크(들)는 어떤 모습일까? 인공 초지능에 도달했다는 걸 우리는 어떻게 알 수 있을까? 어쩌면 깁슨이 몇몇 소설에서, 혹은 스파이크 존즈의 영화 그녀가 넌지시 보여주듯, 우리는 알아차리지도 못할지 모른다. 그들은 우리를 그냥 지나쳐 갈 것이고, 우리는 영문도 모른 채 세계에 대한 인지적 지배권을 잃게 될 것이다. 아니면 애초에 그다지 좋은 질문이 아닐 수도 있고.
Y a cada colaborador se le paga por su trabajo. Las dos cosas dependen de los suscriptores.