Benchmarking: Yapay zekâyı ölçme yarışı
Bir yapay zekânın "düşündüğünü" mü, yoksa sadece veri mi kustuğunu nasıl anlarız? Dijital zihinleri kanmadan değerlendirmenin bilimi.

Bir yapay zekânın "düşündüğünü" mü, yoksa sadece veri mi kustuğunu nasıl anlarız? Dijital zihinleri kanmadan değerlendirmenin bilimi.

Bana sabit bir nokta verin, dünyayı yerinden oynatayım. - Arşimet
Genel olarak yapay zekâ geliştirmenin tam kalbinde bir silahlanma yarışı var, ama ben özellikle dile uygulanan yapay zekâlara odaklanacağım. Bir yapay zekâ sisteminin geliştirilmesi, bir dizi yeteneğe ulaşmayı hedefler; bunlar ilk etapta bilişsel, insana özgü ya da insanların işine yarayan yeteneklerdir. Metin yazmak, anlamak, çevirmek, özetlemek, kibar olmak, adil olmak, istihbarat raporu hazırlamak, Avrasya'yla hep savaş halinde olduğumuzu ilan etmek, kandırmak, muhalifleri fişlemek, termonükleer savaşlar kazanmak vs. Bu görevlerin hangisi olursa olsun, sistemin işi iyi mi kötü mü yaptığını ve özellikle aynı amaçla tasarlanmış başka sistemlerle nasıl kıyaslandığını değerlendirmenin bir yolu olmalı.
Bu, modelleri tasarlayanları (ya da yetiştirenleri) da, onları satın almak ya da kullanmak isteyenleri de etkileyen bir sorun. Yapay zekâ sistemleri yaratanların hedefleyebilecekleri ölçülebilir amaçlara ihtiyacı var; modelleri satın almak ya da kullanmayı düşünmek isteyenler ise hangisinin en iyisi olduğunu bilmek istiyor. Peki bu nasıl yapılır? Bir yolu bunu vibes ile yapmak; yani herkesin bir dil modelini kullanırken yaptığı şeyin sofistike versiyonu. Kullanıyorsun, çözemeyeceğini düşündüğün bir problem veriyorsun, çözüyor, çenen yere düşüyor ve "vay be, inanılmaz bir şey bu" diyorsun. Ama çoğumuzun fark ettiği gibi, bu şans eseri olabilir ya da tam da modelin eğitildiği türden bir problem olabilir; bunu iyi yapmış olması, başka şeyleri de iyi yapabileceğini garanti etmez.
Yapay zekâ sistemleri yaratanların hedefleyebilecekleri ölçülebilir amaçlara ihtiyacı var; modelleri satın almak ya da kullanmayı düşünmek isteyenler ise hangisinin en iyisi olduğunu bilmek istiyor. Peki bu nasıl yapılır?
Dil modellerinin performansını değerlendirmenin daha sofistike bir yolu, uzmanlara modelleri doğrudan becerileri/bilgileri üzerinden değerlendirtmek. Bu biraz daha iyi işliyor ama çok daha pahalı, yavaş ve yine de yanılmaya açık. Bir başka yol da modelleri vibes ile birbirleriyle yarıştırmak (chatbot arena'da ELO sıralamalarıyla yapıldığı gibi): Sana hangileri olduğunu söylemeden iki model veriyorlar ve hangisini daha çok beğendiğini söylüyorsun. Ne var ki bunun da göz kararı değerlendirmeyle temelde aynı sorunları var: salt görüşlere dayanıyor. Epey bir şey veriyor ama yetmiyor. Dördüncü bir yol, bir modeli alıp beyin diseke eder gibi ortadan açmak ve neler olduğuna bakmak. Bunlar "beyaz kutu" analizleri (kara kutunun tersi, yani içinde ne olduğunu görebildiğin bir kutu); ya bazı modeller için pek az bilgi veriyorlar ya da fazlasıyla yavaş ve uygulanamazlar. Üstelik ne OpenAI ne de Anthropic sana altın token yumurtlayan tavuklarına erişim verecek. Geriye onlara standart sınavlar yaptırmak kalıyor.
"Benchmark" kelimesinin pek çok anlamı var ve kulağa bir tür "test tezgâhı" ya da benzeri bir şeyden bahsediyormuşuz gibi geliyor, ama kökeni bu değil. Etimoloji her zaman önemli değildir ama bu örnekte meseleyi anlamaya yardımcı olabilir. İngilizce "benchmark" kelimesi, yeryüzünün ölçümlerini yapmakla uğraşan ve topograflarla kadastrocuların işine yarayan jeodezi disiplininden geliyor. Şehirlerin farklı yükseklikleri var ve bu da farklı yapıların göreli yüksekliğini hesaba katmayı gerektiriyor; örneğin boru hatlarının güzergâhını çizmek ve benzeri işler için, bir şehirde suyun akışını hesaba katmak için.
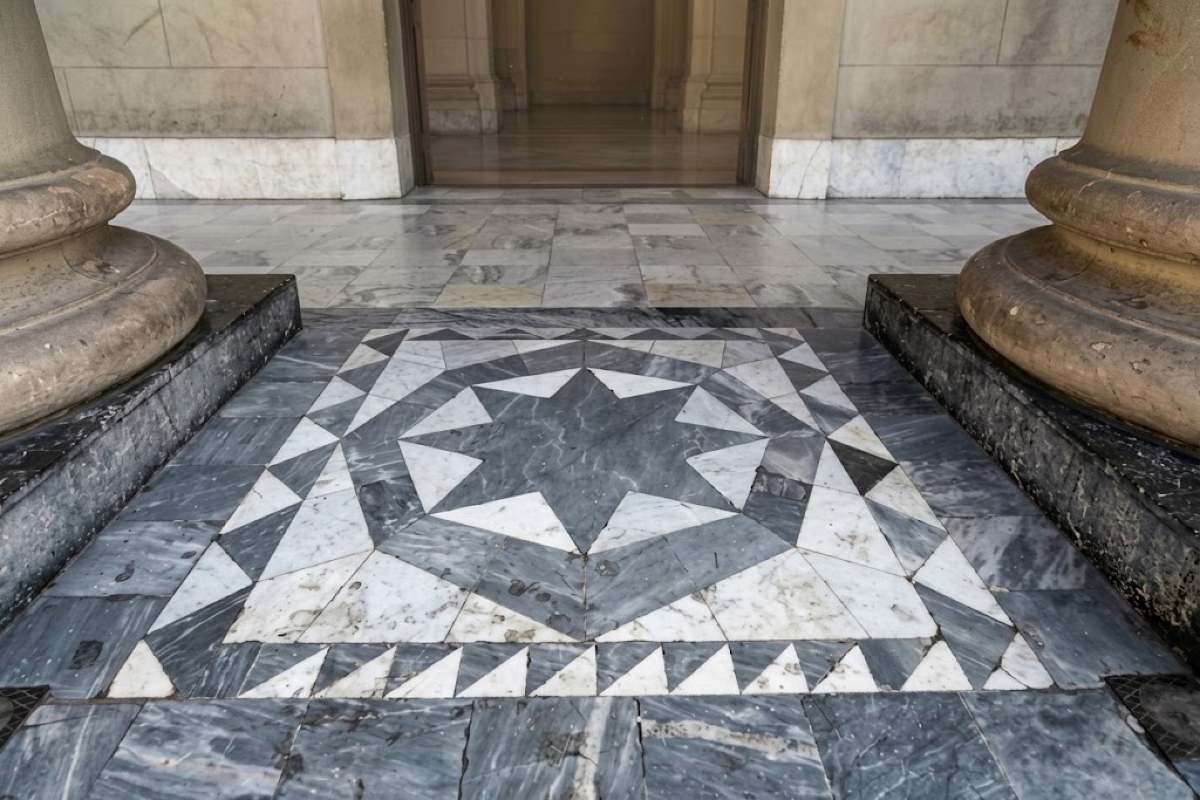
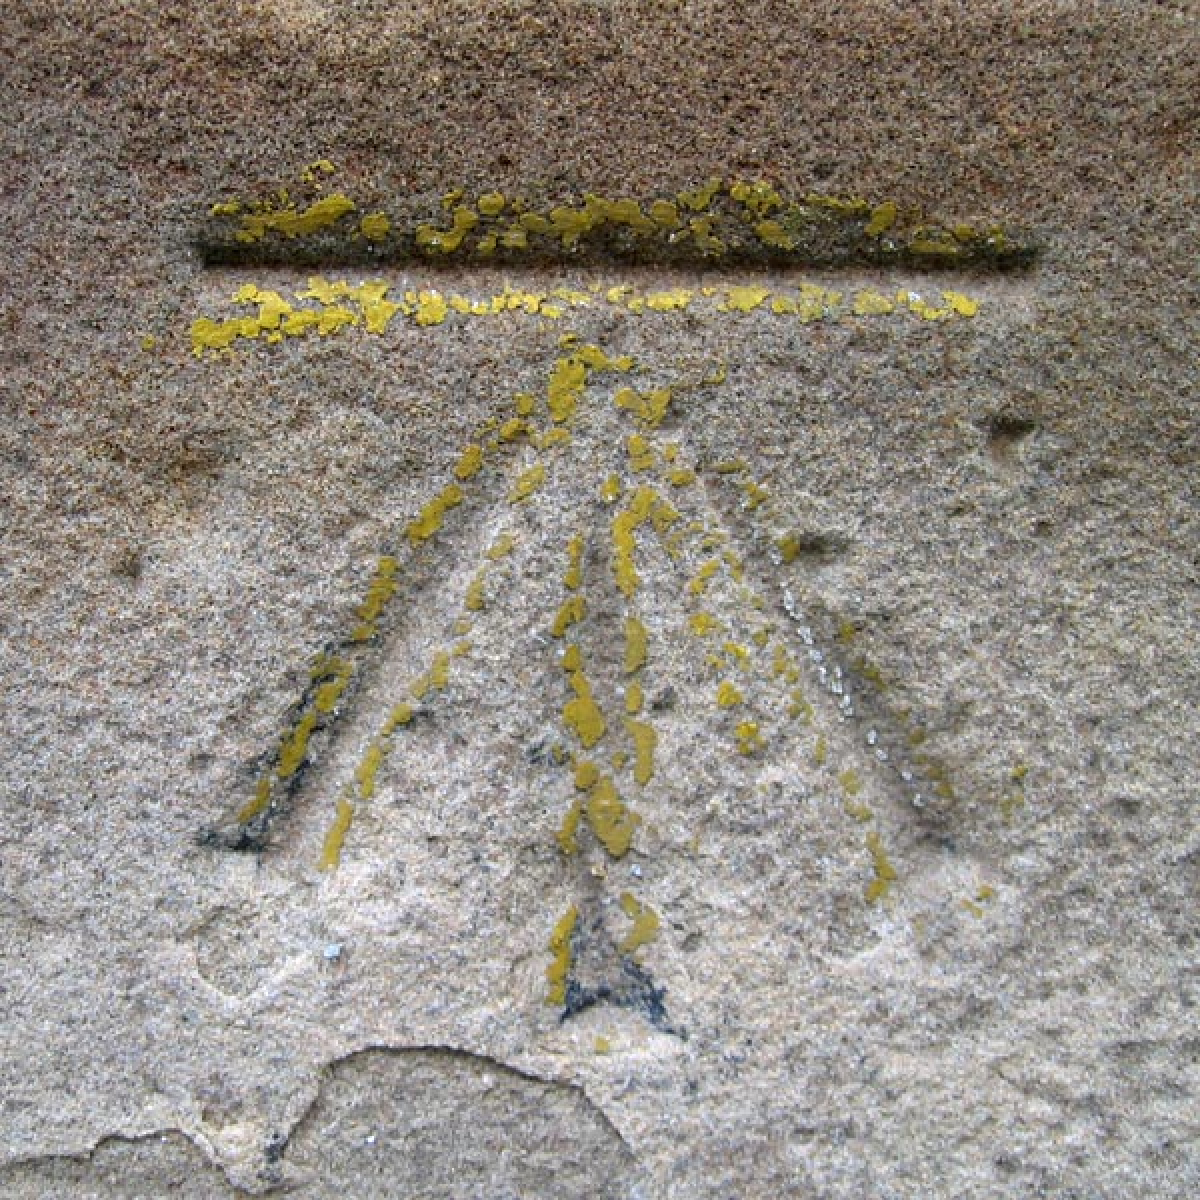
Bu amaçla modern şehirlerdeki yetkililer (modern derken aşağı yukarı 18. yüzyıldan bu yanını kastediyorum) şehrin farklı yerlerine jeodezik "sabit noktalar" (İspanyolcada jeodezik benchmark'lara böyle diyoruz) işaretlemeyi üstlendiler. Şehirlerin bir referans sabit noktası ya da sıfır noktası vardır; Buenos Aires Özerk Şehri'nde bu nokta Katedral'in girişinde bulunuyor. Bir rüzgâr gülü. Başkentteki bütün jeodezik sabit noktalar, bu sıfır noktasına göre göreli bir yükseklikte işaretlenmiştir.
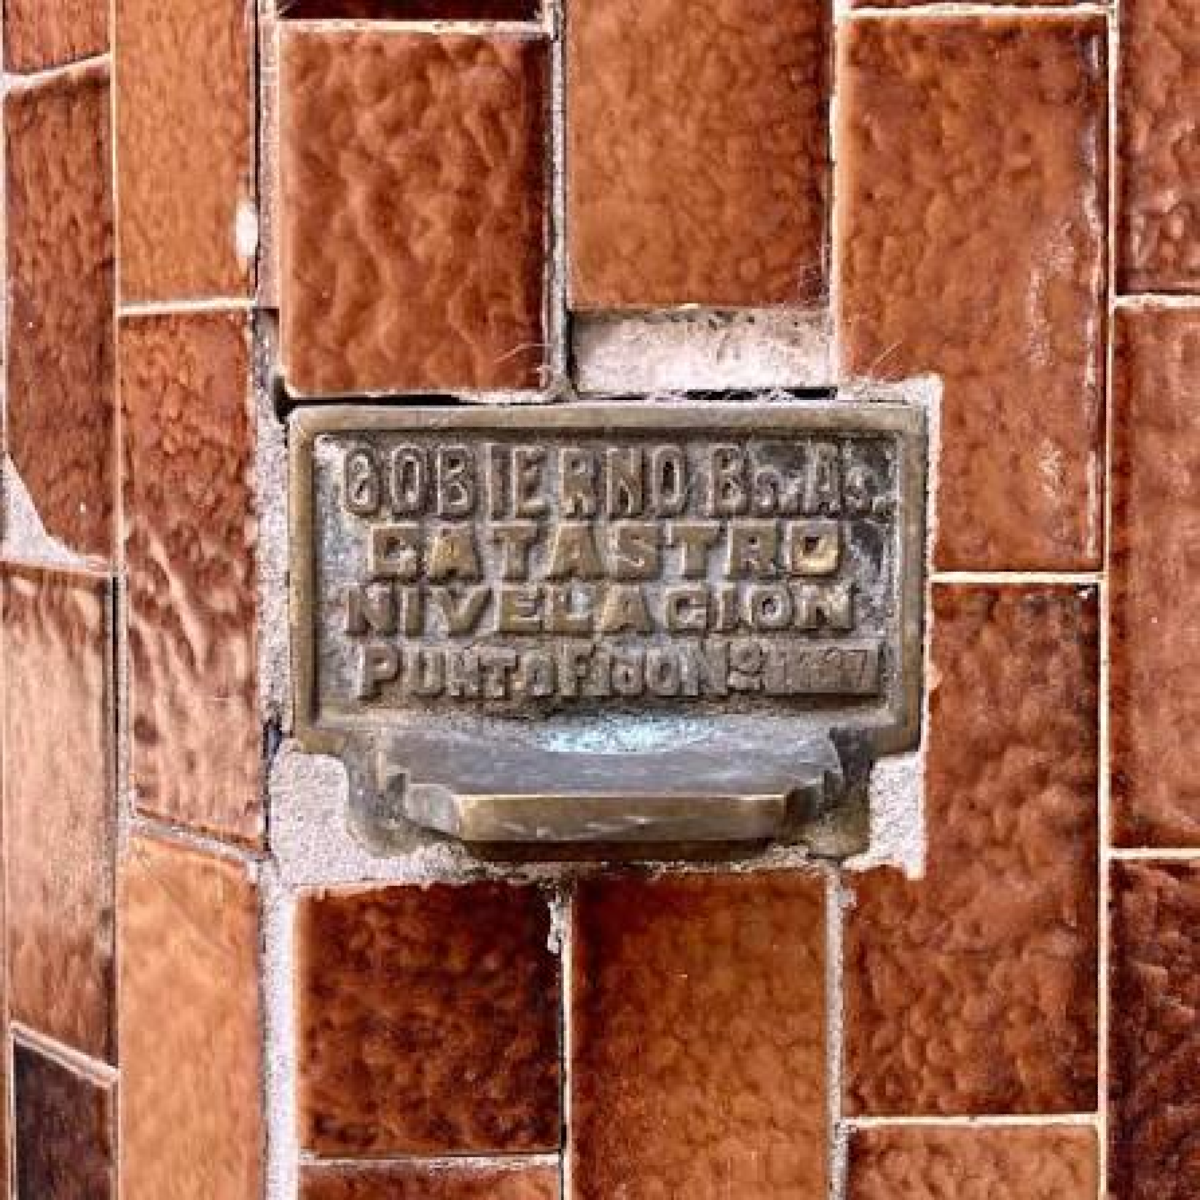
Şehrin temel sabit noktası, yani Katedral'deki, şöyle görünüyor:
Ama ülkenin dört bir yanında, Ulusal Coğrafya Enstitüsü'nün (Askerî Coğrafya Enstitüsü'nün halefi) yerleştirdiği sabit noktalar var:
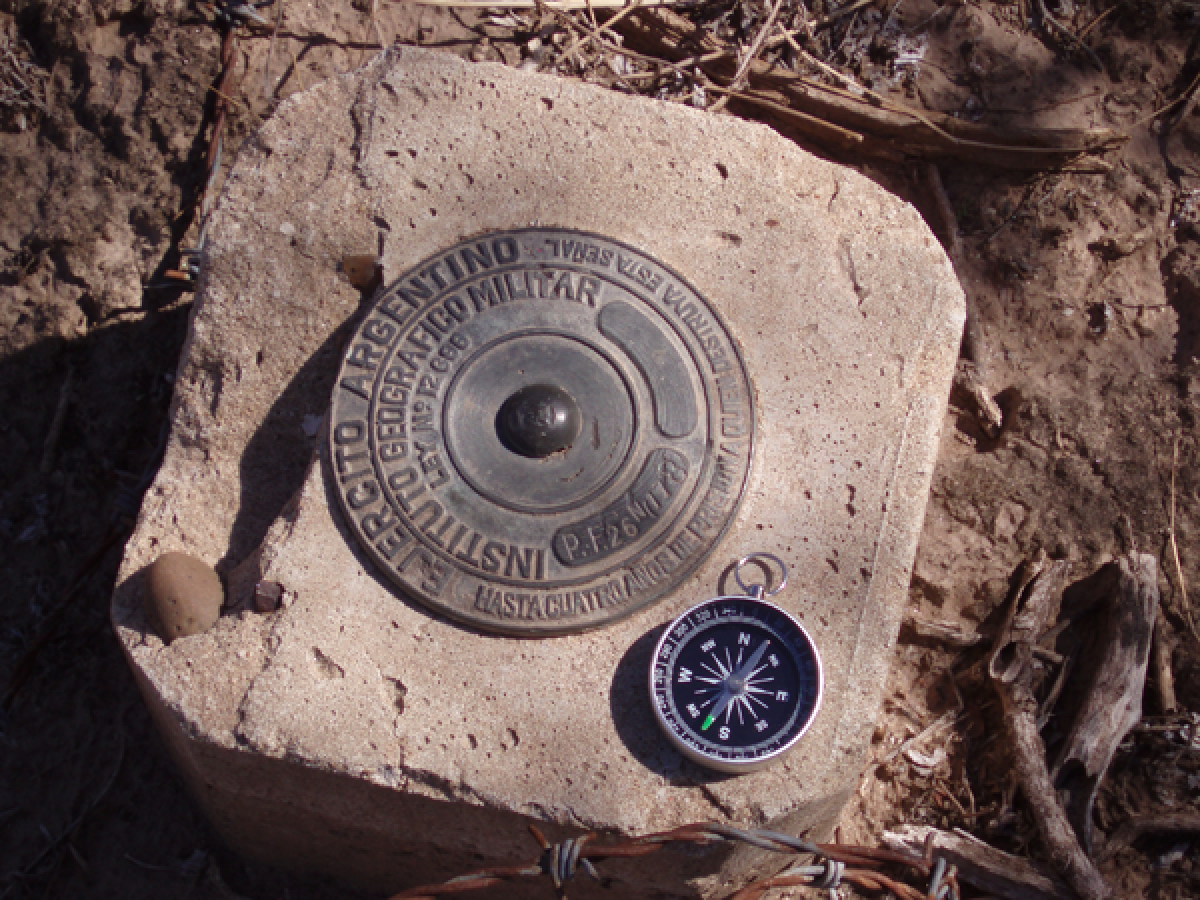
Bu sayede kadastrocular, topograflar, haritacılar, mimarlar ve inşaat mühendisleri, işlerinde kullanmak üzere belli bir yükseklik ve coğrafi konuma göre haritalanmış göreli referans noktalarına sahip oluyor. Bugün bunun çoğu GPS ile yapılıyor, ama hiçbir ülke (en azından şimdilik) bu kadar hayati bir bilgi için tamamen bir uydu sistemine bel bağlayacak kadar aptal değil. Duvara gömülmüş bir parça demirle bir sürü çizelgeyi hiçbir şey yenemez (low tech, high life derdi Ruocco).
"Benchmarking"in özgün kullanımından (taş ya da granit üzerine, üstüne bir nivo dayanacak yatay işaretler [mark] kazımak ve nivelman mirası için bir tezgâh ya da oturak ["bench"] oluşturmak) yola çıkarak, farklı alanlarda bu terim, aynı türden birkaç şeyi karşılaştırmaya yarayan (göreli) bir performans testini ifade etmek için kullanılıyor. Bilişimde biz gamer'lar bunları, sistemimizin belirli oyunlardaki performansını ölçmek ya da makinemizin diğerlerine kıyasla ne kadar iyi olduğuna dair kabaca bir fikir veren referans testleri çalıştırmak için kullanırız.
Makine öğrenmesi sistemlerinde yaygın bir uygulama, modeli eğitmek için bir dataset (bir veri kümesi) alıp bunu %80 eğitim ve %20 değerlendirme olarak bölmektir. %80'lik kısımla eğitilen model, değerlendirme veri kümesini hiç görmeden, değerlendirme kümesindeki verileri tahmin etmede yüksek performans gösteriyorsa, modelin eğitim veri kümesinde gördüğü verilerden yola çıkarak genelleme yaptığı ve bir anlamda "öğrendiği" söylenebilir. Aksi halde hayır. Yalnızca daha önce gördüğü problemleri çözebilen bir model hiçbir işe yaramaz.
Pratikte şöyle düşünebiliriz: Eğitim veri kümesinde bir sürü coğrafya, cebir ya da matematiksel analiz problemi, bir dizi olası cevap ve doğru cevap var (bunlar dilbilgisi problemleri ya da Magic kartları bilgisine dair sorular da olabilir). Değerlendirme veri kümesinde ise eğitimde karşısına çıkmamış problemler var ve cevabı modele göstermiyoruz, onu değerlendirmek için saklıyoruz. Ona bir dizi seçenek veriyoruz (multiple choice sınav gibi) ve tutturup tutturmadığına bakıyoruz. Doğru cevap oranı bize modelin o veri kümesindeki isabetini, yani accuracy'sini verir; bunu da bir benchmark olarak alabiliriz.
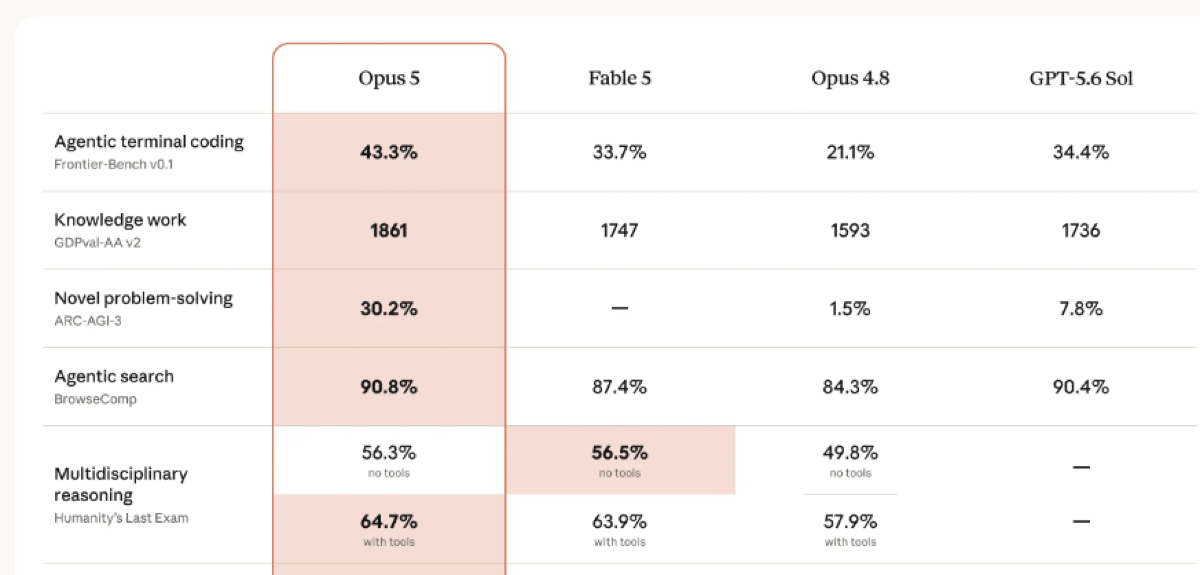
Bu anlamda, pek çok dil modeline uygulanabilen bir değerlendirme veri kümesi (ister bir eğitim veri kümesinin parçası olsun ister olmasın) bir benchmark işlevi görür.
Şimdi, nasıl ki makinenin bir grafik benchmark'ında belli bir puan alması kendi başına önemli değil de, makinenin oyun oynarken, video render ederken ya da ne yapmak istiyorsan onu yaparken (ki o şey benchmark değil) neler yapabileceğine dair bir işaret olarak önemliyse, dil modellerinde de benzer bir durum var. Bir dil modelinin benchmark'ta iyi olmasını, bu kendi başına bir anlam taşıdığı için önemsemezsin; iyi yapması ancak, sana onun benchmark olmayan işlerde neler yapabileceğine dair bir şey söylüyorsa önemlidir.
Bir dil modelinin benchmark'ta iyi olmasını, bu kendi başına bir anlam taşıdığı için önemsemezsin; iyi yapması ancak, sana onun benchmark olmayan işlerde neler yapabileceğine dair bir şey söylüyorsa önemlidir.
Bu, biz öğretmenlerin sınav yaparken yaptığımız şeye çok benziyor. Değerlendirme araçları kendi başlarına önemli değildir. Pek çok lise öğrencisi (ve pek çok üniversite öğrencisi) zaman zaman, öğretmenlerinin verdiği ödevlerin ya da yazdıkları denemelerin, okurken öğretmenin bir şey kazanacağı bir tür sipariş olduğu (yanlış) fikriyle hareket eder; sanki öğretmen bir şey öğrenecekmiş gibi. Sanki ödev, bir şirketin bir danışmanlık firmasına sipariş ettiği bir tür rapormuş gibi. Biz öğretmenlerin öğrencilerimizden bir şey öğrenemeyeceğimizi söylemiyorum (her an öğreniyoruz), ama onları değerlendirmeye tabi tutmamızın sebebi bu değil.
Değerlendirmelerin rollerinden biri teşhistir (başkaları da var, mesela biçimlendirici bir rol: Hedeflenen beceriyi yavaş yavaş kazanman için kafa patlatmanı istiyorum): Nasıl gittiğini bilmek istiyorum ki ileride meslek hayatında benzer problemleri çözerken nasıl bir performans göstereceğine dair bir fikrim olsun (örneğin üniversite düzeyinde). Yani insanlara yapılan sınavlar çoğu zaman, bir kişiye benzer problemleri çözme yatkınlığı olarak anlaşılan bir yetkinlik atfetmek için gerekçe edinmeye yarayan araçlardır. Birini tanıyıp bize birkaç kez yalan söylediğini görmenin ve bunu ona yalancı olma özelliğini atfetmek için yeterli sebep saymanın sofistike bir akrabası gibi. Yalancı damgası yemek tehlikelidir (yalancı çoban masalındaki gibi), çünkü insanlar sana yalan söylemeye devam edecekmişsin gibi davranır ve sana böyle davranırlarsa artık seni ciddiye almazlar (bu kendine özgü bir sosyal ölüm türüdür). Buna karşılık avukat damgası yemek, bölümdeki bütün hocalarla birer raund kapışıp hepsini yendiğin anlamına gelir (tıpkı Ash'in Pokémon ustalarını yenmesi gibi) ve bunu gelecekte de yapmaya devam edebileceğin varsayılır.
İşte nasıl ki ehliyet sınavı salt bir izin değil, bir yetkinlik atfına ve beraberinde gelen sorumluluğa dayanan bir izinse (iyi araba kullanabiliyorsan, kötü kullanmaktan da sorumlusun), aynı şey daha soyut yetkinlikler için de geçerli. Örneğin bilişsel kapasiteler. Psikometristler uzun zamandır daha soyut yetkinlikleri değerlendirmenin yollarını tasarlamaya çalışıyor; yetkinliklerin ta kendisi, insan yetenek ehliyetlerinin Kutsal Kâsesi de dahil: zekâ.
Yapay zekâ uzmanı François Chollet'nin (ARC-AGI benchmark'ının yaratıcısı) deyişiyle, bir görevi çözme kapasiten ne kadar becerikli olduğunu gösterir; zekâ ise yeni görevleri çözmek için yeni beceriler edinmede ne kadar verimli (mesela hızlı) olduğunu ölçer. Yani birinin zeki olduğunu söylediğimizde, onun belirli bir şeyi yapmaya muktedir olduğunu söylemiyoruz; sadece, isteği, fırsatı ve vakti olsa, söz konusu beceride ustalaşmanın ona başkalarından daha az zamana ya da çabaya mal olacağını söylüyoruz (hem kendi gözlerinde hem başkalarının gözünde hiçbir işe yaramayan bu kadar çok zeki insanın varlığını da ancak böyle bağdaştırabiliyoruz).
Dolayısıyla zekâ doğrudan ölçülemez, çünkü becerinizin büyük kısmı psikometristlerin "kristalize zekâ" (ya da kristalize g faktörü, Gc) dediği şey olabilir; karşısında da "akışkan zekâ" (ya da Gf) durur. Bilişsel becerileri ölçmekte uzmanlaşmış psikologlar kristalize zekâyla pek ilgilenmez, çünkü bir konuda çok şey bilip yine de aptalın teki olmak mümkündür (bunu onlar söylüyor, bana kızmayın). "idiot savant" (dahi aptal) figürü, bilgileri hatırlayan ama ezberlediği bilgilerin ötesinde akıl yürütemeyen kişidir. Bunu belki de en iyi Borges'in "Hafızası Güçlü Funes" öyküsü anlatır.
Bu testler zekânızı doğrudan ölçmüyor (öyle bir şey mümkün görünmüyor); sonucunuzun hangi yaş ortalamasına benzediğini ölçüyor. Kendi yaşınızdan büyük bir yaşın ortalamasına benzer bir puan alırsanız, bu, bilişsel becerileri edinmede yaşıtlarınızdan daha verimli olduğunuz anlamına gelir. Puanınız ne kadar büyük bir yaşın ortalamasıyla örtüşürse, oran da o kadar yükselir: (ZihinselYaş/Yaş)*100 = IQ.
Yüksek IQ'suyla hava atan 20 yaşındaki gençlere bir uyarı notu: Bu, en iyi ihtimalle 30 yaşındaki insanların ortalama puanını aldığınız anlamına gelir (zihinsel yaşı 36 olan 18 yaşındaki biri 200 IQ puanına sahip olurdu, ki bu ölçülebilir sınırdır; 130 puan ise 18 yaşında olup IQ testlerinde 24 yaşındaki biri gibi performans göstermektir...), yani laf soktuğunuz kişilerin ta kendisi gibi. 30 yaşında bir erkek olarak yüksek IQ'ya sahip olmak, yalnızca 40'ına basmadan önce hayatınla ne yaptığını bilmemenin bunalımına girebileceğin, sevgilinin seni terk edebileceği, kendine bir Harley Davidson (ya da mirasa konmadıysan GTA VI oynamak için bir Playstation) alabileceğin anlamına gelir. Tebrikler!
Kuşaklar arası aptalca savaşların sonunu yalnızca ölüler gördü. IQ (ve onun hakkındaki söylem) bu savaşların sadece bir başka cephesi. Her hâlükârda şunu hatırlayalım: Newton'la aynı IQ'ya sahip olmanın kulağa hoş gelmesinin tek sebebi (bol şans bu arada), Newton'ın hayatında ilginç bir şey yapmış olmasıdır. Ben olsam ona odaklanırdım.
Aynı soru LLM'ler için de sorulabilir: Zekiler mi, yoksa verileri ezberlediler mi? Örneğin Ted Chiang (pek meşhur bilimkurgu yazarı), bunların yalnızca bir tür veri sıkıştırma olduğunu söylüyor (.zip ya da .rar gibi). Kayıplı bir sıkıştırma türü (lossy compression): LLM'lerin internetin bulanık bir .jpeg'i olduğu imgesini kullandı. Peki, insanlığın dijitalleştirilmiş tüm yazılı verilerini blendırdan geçirip içmiş dil modellerini, yalnızca kusmadıklarını ve gerçek bir kavrayışa ulaşabildiklerini iddia edebilmek için nasıl değerlendireceğiz? İşte bin trilyon dolarlık soru bu, ve benchmark biziz.
Yapay Genel Zekâ, bizim doğal genel zekâmızın karşılığıdır. Dolayısıyla bu fikirleri dil modellerine uyarlamaya çalışmak için, zeki olduğumuzu nasıl iddia edebildiğimizi, neler yapabildiğimizi, birbirimize gerçekten zekâ atfetmemizi sağlayan şeyin ne olduğunu düşünmek gerekiyor. Herhangi bir bilişsel görevde genel olarak iyi performansı öngören değerlendirmeler tasarlayabilirsek, zeki olduklarına inanmak için sebeplerimiz olur. Bu da "genel zekâ" denen teorik bir yapı, yani zekânın ne olduğunu düşündüğümüze dair bir model tasarlamak ve dil modellerinde benchmark olarak kullanılacak görevler (sınavlar) hazırlamak demek; öyle görevler ki LLM'ler bunları çözdüğünde, değerlendirdiğimizi varsaydığımız o şeye (teorik yapıya) sahip olduklarını söylemek için gerçek sebeplerimiz olsun. "Bunu çözebiliyorsa paramı ona emanet ederim" diyeceğimiz türden şeyler (ya da ABD veya Çin'seniz nükleer silahlarımı).
İnsanlığın dijitalleştirilmiş tüm yazılı verilerini blendırdan geçirip içmiş dil modellerini, yalnızca kusmadıklarını iddia edebilmek için nasıl değerlendireceğiz? İşte bin trilyon dolarlık soru bu, ve benchmark biziz.
Ama iş o kadar kolay değil. Bugün dil modeli tasarımı, hangi araştırma yönlerinin izleneceğini bilmek için benchmark'lara ihtiyaç duyuyor. Yeni dil modeli mimarileri icat etmenin, bu yeni mimarilerin öncekilerden daha iyi olup olmadığını bilemiyorsak tutunacak pek bir dalı yok. Daha iyi görünmeleri yetmez. Daha da kötüsü, kamuya açıklanan her benchmark'ın sonraki modellerin eğitim verisinde yer alacağını peşinen kabul edebiliriz; dolayısıyla çözülmesinin bize verdiği bilgi sınırlıdır: Bir benchmark yayımladığımızda (amaç tekrarlanabilir ve adil olması, bunu sağlamanın bir yolu da herkese açık olması) Anthropic ya da Alibaba'dakiler modeli o benchmark üzerinde eğitebilir; böylece modellerinin benchmark'ta mükemmel olmasını garantilerler, ama model benchmark'ın ölçmek için tasarlandığı beceride illa ki iyi olmaz.
Sektörün de kamuoyunun da daha iyi değerlendirmelere ihtiyacı var, ama bu nankör, pahalı ve zor bir iş, inanın bana. Sınav yaptığımızda öğretmenleri kimse sevmez, dil modeli değerlendirmelerinde de durum pek farklı değil. Bu makineleri tasarlamakta, onları değerlendirmekten çok daha fazla para var. Üstelik bu, hakkında bir referansımız olan bir şeye bağlı sorun sadece: kendi yeteneklerimiz, hem de onları ne insanlarda ne de makinelerde doğru dürüst ölçemesek bile. Asıl büyük soru şu: Silicon Valley'nin Makinedeki-Tanrı'sı için benchmark (ya da benchmark'lar) nasıl görünürdü? Bir yapay süper zekâya ulaştığımızı nereden bilecektik? Belki de Gibson'ın bazı romanlarında ya da Spike Jonze'un Her filminde sezdirilen şey olurdu: Fark etmezdik bile. Yanımızdan geçip giderlerdi ve dünya üzerindeki bilişsel hâkimiyetimizi haberimiz olmadan kaybetmiş olurduk. Ya da belki soru o kadar da iyi bir soru değildir.
Y a cada colaborador se le paga por su trabajo. Las dos cosas dependen de los suscriptores.