基准测试:一场评估人工智能的竞赛
怎么判断一个AI是在“思考”,还是只是在反刍数据?评估数字心智而不被它糊弄的科学。

怎么判断一个AI是在“思考”,还是只是在反刍数据?评估数字心智而不被它糊弄的科学。

给我一个支点,我就能撬动地球。——阿基米德
整个人工智能开发的核心里有一场军备竞赛,不过我这里要专门聊的是语言类的AI。开发一个AI系统,目的是让它具备一系列能力,原则上是认知层面的、属于人类的或者对人类有用的能力。不管是写文章、理解、翻译、摘要、讲礼貌、讲公平、出情报报告、宣布我们一直在和欧亚国打仗、骗人、给反对派建黑档案、打赢全球热核战争,等等。不管是哪项任务,都得有办法评估这个系统干得好还是不好,尤其是它和其他为同一目标设计的系统相比怎么样。
这个问题既困扰设计(或者说培育)模型的人,也困扰想采购或使用模型的人。打造人工智能系统的人需要可衡量的目标去瞄准;想采购模型或考虑使用模型的人想知道哪个最好。可这事儿到底怎么弄?嗯,一种办法是凭vibes,这其实就是每个人用语言模型时都在干的事的高级版。你拿来用,丢给它一个你觉得它解决不了的问题,结果它解决了,你下巴都掉了,说一句“卧槽,这玩意儿太牛了”。但很多人都已经意识到,这可能只是运气,或者恰好就是模型专门训练过的那类问题,它把那个做好了,并不能保证它别的事也能做好。
打造人工智能系统的人需要可衡量的目标去瞄准;想采购模型或考虑使用模型的人想知道哪个最好。可这事儿到底怎么弄?
评估语言模型表现的一种更高级的办法,是请专家直接考察它们的技能/知识。这样效果稍好一些,但贵得多、慢得多,而且照样会出错。还有一种办法是让模型凭vibes互相PK(就像chatbot arena那样,用ELO排名):给你两个模型,不告诉你是哪两个,你说你更喜欢哪个。可这基本上和肉眼评估有一样的毛病:靠的仅仅是个人看法。能说明不少问题,但不够。第四种办法是拿一个模型从中间剖开,像解剖大脑那样,看看里面发生了什么。这叫“白盒”分析(和黑盒相反,就是一个你能看到里面装了什么的盒子),但这种分析要么对某些模型来说几乎提供不了什么信息,要么太慢、根本不可行。更别提无论是OpenAI还是Anthropic 都不会让你碰它们那只下金token的母鸡。剩下的办法就是给它们考标准化考试。
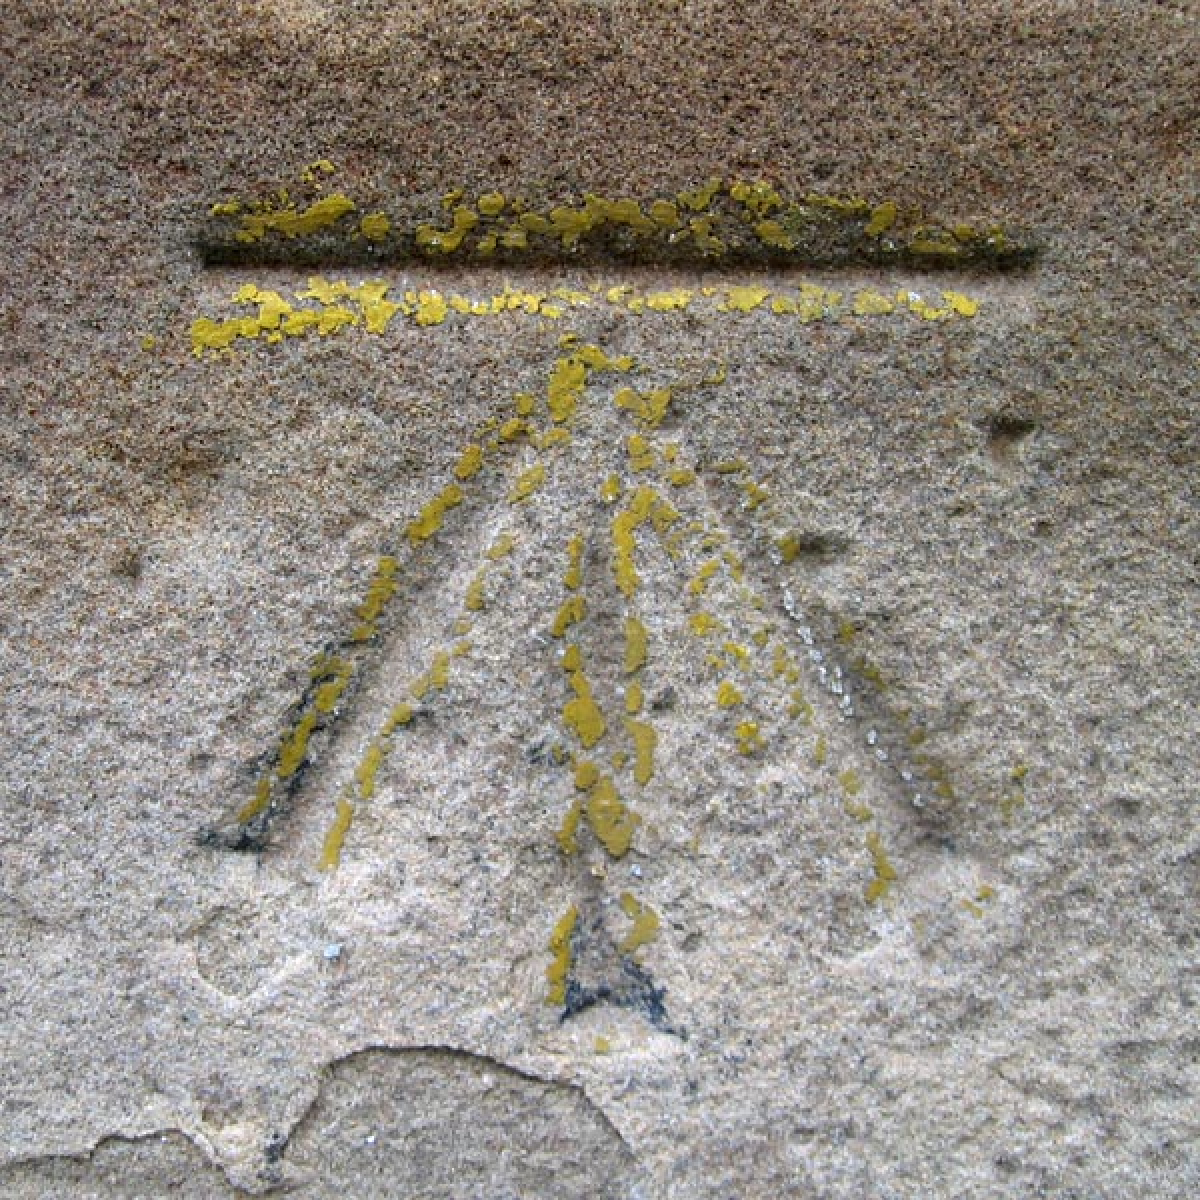
“benchmark”这个词有很多含义,听起来像是在说某种“测试台”之类的东西,但它的来源并非如此。词源不一定总是重要,但在这里有助于理解问题。英语单词“benchmark”来自大地测量学,这门学科负责测量地球,为地形测量员和土地测量员提供基础数据。城市各处高度不同,需要考虑不同建筑之间的相对高程,比如铺设管道之类的工程,要考虑城市里水往哪儿流。
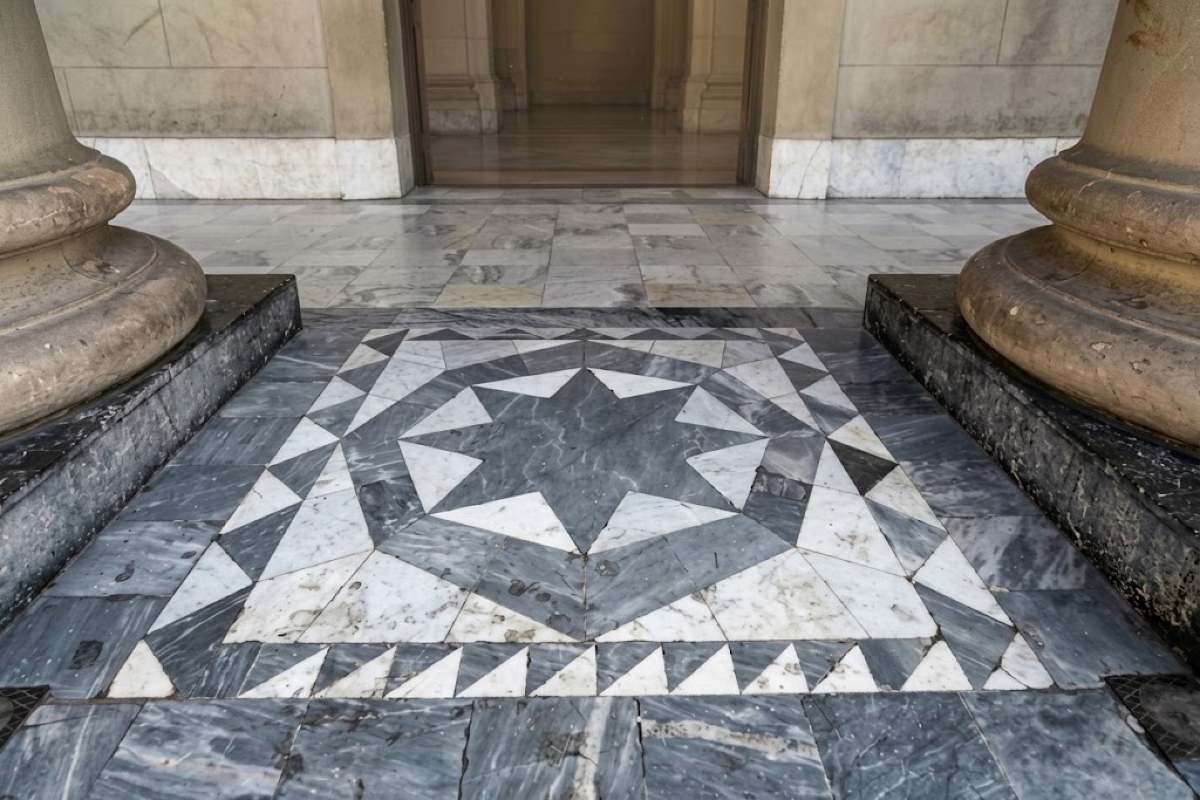
为此,现代城市(我说的现代,大概是指18世纪以来)的管理部门在城市各处标出了大地测量“固定点”(西班牙语里我们就这么称呼大地测量的benchmark,也就是水准点)。每座城市都有一个参考固定点,或者叫零点,布宜诺斯艾利斯自治市的零点就在大教堂门口,是一个罗盘玫瑰图案。首都所有的大地测量固定点,都标注了相对于这个零点的高度。
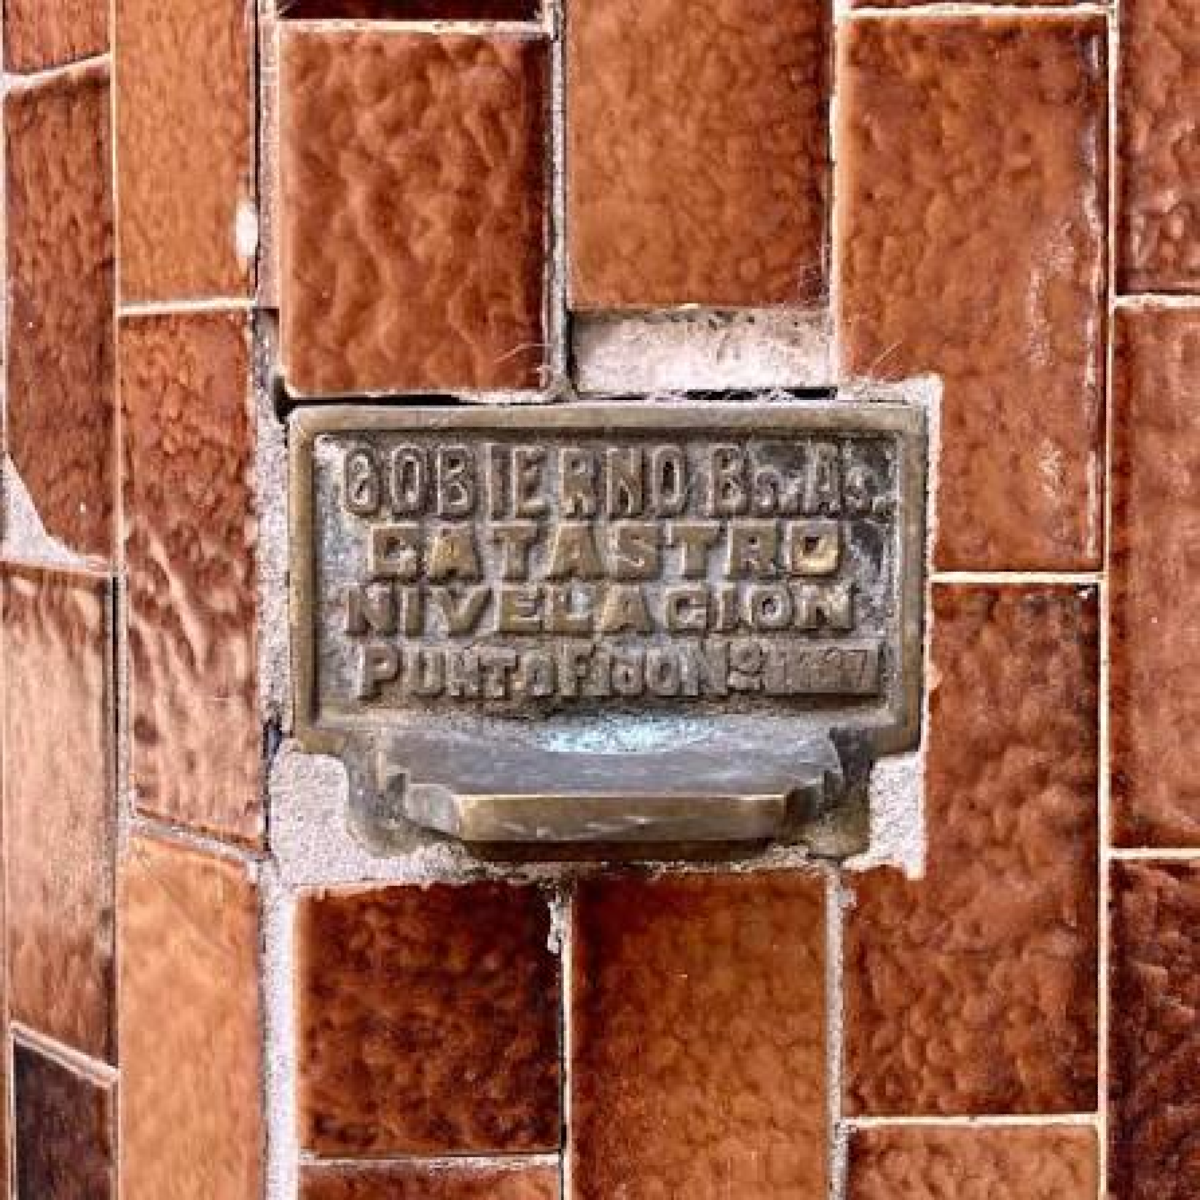
城市的基本固定点,也就是大教堂那个,长这样:
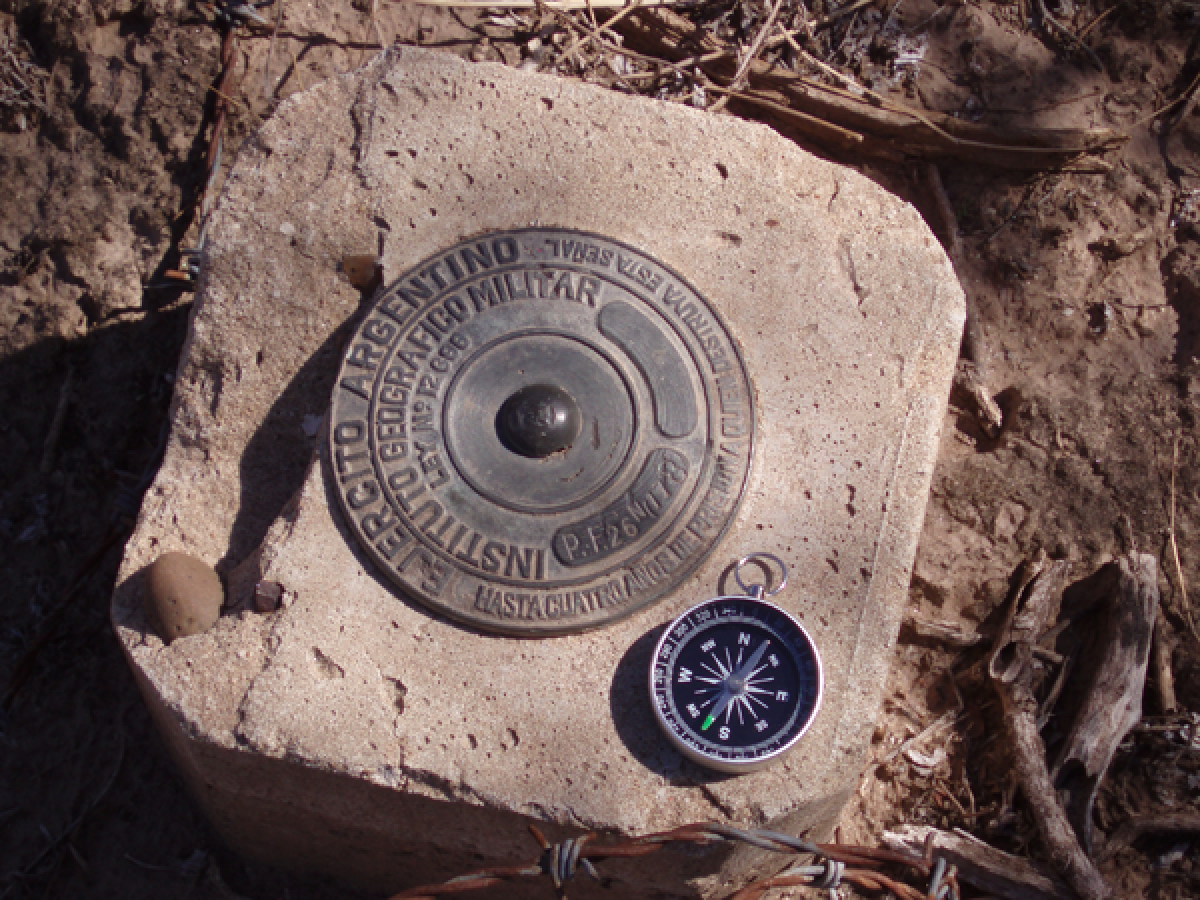
不过全国各地都有固定点,由国家地理研究所(前身是军事地理研究所)设置:
这样一来,土地测量员、地形测量员、制图师、建筑师和土木工程师就有了相对的参考点,这些点都对应着确定的高度和地理位置。如今很多工作都用GPS来做,但没有哪个国家蠢到(至少目前还没有)把这么关键的信息完全押在一套卫星系统上。什么都比不上一块嵌在墙里的铁疙瘩加上一大堆表格(Ruocco会说:low tech, high life)。
作为“benchmarking”原始用法的引申(在石头或花岗岩上刻出水平标记[mark],用来架放水准仪,为水准尺形成一个台或座["bench"]),很多领域都用这个词来指一种(相对的)性能测试,用来比较同类的不同东西。在计算机领域,我们这些玩家会用它在某些游戏或参考测试里跑分,大致了解自己的机器和别人的比起来有多强。
机器学习系统的常规做法是拿一个dataset(数据集)来训练模型,把它分成80%的训练集和20%的评估集。如果模型在80%的数据上训练,从没见过评估集,却能高水准地预测评估集里的数据,就可以说模型从训练集里见过的数据中实现了泛化,在某种意义上“学会了”。否则就没有。一个只能解决见过的问题的模型,毫无用处。
实际操作中可以这么理解:在训练数据集里,我们有一大堆地理、代数或数学分析题,一系列备选答案,以及正确答案(也可以是语法题,或者万智牌知识题)。在评估数据集里,是没在训练中出现过的题目,而且我们不给模型看答案,留着用来考它。我们给它几个选项(就像选择题考试),看它能不能蒙对。答对的比例就是它在这个数据集上的准确率,也就是accuracy,可以拿来当作一个benchmark。
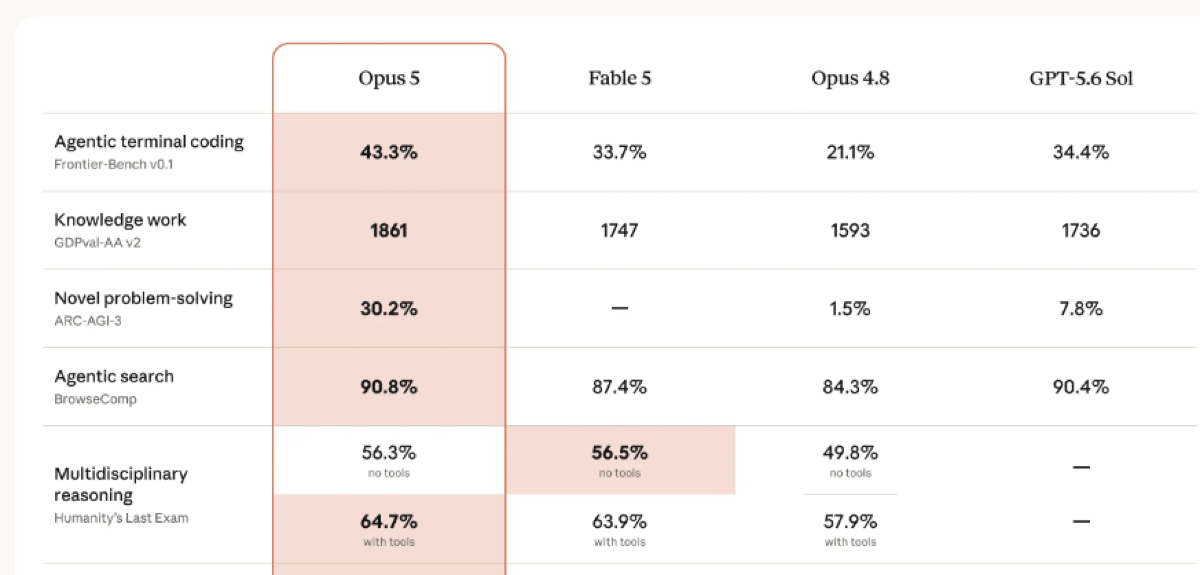
从这个意义上说,一个可以拿去考很多语言模型的评估数据集(不管它是不是某个训练数据集的一部分),扮演的就是benchmark的角色。
话说回来,你的机器在某个显卡benchmark里拿到多少分,本身并不重要,重要的是它能说明你的机器在你拿来打游戏、渲染视频或者干别的什么(反正不是跑benchmark)的时候能表现如何。语言模型也差不多。你在乎一个语言模型在这个benchmark上表现好,并不是因为这本身有什么意义;你在乎它考得好,是因为它考得好能告诉你它在benchmark之外能干些什么。
你在乎一个语言模型在benchmark上表现好,并不是因为这本身有什么意义;你在乎它考得好,是因为它考得好能告诉你它在benchmark之外能干些什么。
这和我们当老师的出考试题非常像。评估工具本身并不重要。很多中学生(还有很多大学生)有时会抱着一种(错误的)想法:老师布置的作业、他们写的论文,是某种委托,老师读了能有什么收获,好像老师能从中学到点什么似的。好像作业是公司委托咨询机构做的某种报告。我不是说老师不能从学生身上学东西(我们一直都在学),但这不是让他们接受考核的原因。
考核的作用之一是诊断(还有别的作用,比如培养作用:我要你绞尽脑汁,好让你慢慢锤炼出目标技能):我想知道你现在的水平,以便大致判断你将来在职业生涯里解决类似问题时会表现如何(比如在大学阶段)。也就是说:对人的考试,很多时候是一种工具,让我们有理由认定一个人具备某种能力,这种能力被理解为解决类似问题的倾向。这有点像认识一个人、发现他骗了我们好几次、于是认为有充分理由给他贴上骗子标签的高级亲戚。被贴上骗子的标签很危险(就像狼来了的故事),因为大家会把你当成还会继续撒谎的人,而一旦被这样对待,就再也没人把你当回事了(这是一种特殊的社会性死亡)。相反,被认定为律师,意味着你把这个专业的所有教授都挨个打赢了一轮(就像小智挑战各路宝可梦训练家那样),而且大家默认你以后也能继续打赢。
好,就像驾照考试不只是一张许可证,而是一张基于能力认定、并附带相应责任的许可证(如果你有能力开好车,那你就要为开不好负责),更抽象的能力也是一样,比如认知能力。心理测量学家很久以来一直在设法设计评估更抽象能力的方法,包括能力中的那个能力,人类技能许可证中的圣杯:智力。
用人工智能专家François Chollet(ARC-AGI benchmark的创建者)的话说,你解决一项任务的能力说明你有多熟练,而智力衡量的是你获取新能力、解决新任务的效率有多高(比如说有多快)。也就是说,当我们说某人聪明时,并不是说他能够做成某件具体的事,而只是说,如果他有意愿、有机会、有时间,他掌握相关技能所花的时间或力气会比别人少(这就解释了为什么有那么多聪明人,在自己或别人眼里却一无是处)。
因此,智力无法被直接测量,因为你的很多能力可能属于心理测量学家所说的“晶体智力”(或晶体 g 因素,Gc),而不是“流体智力”(或 Gf)。专门测量认知能力的心理学家对晶体智力没那么感兴趣,因为一个人完全可能对某件事知道得很多,却仍然是个白痴(这是他们说的,别怪我)。“idiot savant”(白痴天才)这个形象,指的就是那种能记住大量信息、却无法在记忆之外进行任何推理的人。也许博尔赫斯的《博闻强记的富内斯》比谁都更好地诠释了这一点。
这些测试并不是在直接测量你的智力(这种事看起来根本做不到),它们测的是你的成绩最接近哪个年龄段的平均成绩。如果你考出的分数接近比你年长的人群,就意味着你在获得认知技能方面比同龄人更高效。你的成绩对应的平均分所属的年龄越大,商数就越高:(心理年龄/实际年龄)×100 = 智商。
给那些爱炫耀自己高智商的二十岁年轻人提个醒:这意味着运气好的话,你们能考出三十岁人的平均分(一个心理年龄36岁的18岁青年智商是200分,这已是可测量的上限;130分相当于18岁的人考智商测试考得像24岁的人……),也就是你们天天喷的那帮人。作为男人,三十岁时智商高只说明一件事:你会在四十岁之前因为不知道自己这辈子在干嘛而焦虑、被另一半甩掉、给自己买一辆哈雷戴维森(如果你没有遗产可继承,那就买台 PlayStation 玩 GTA VI),恭喜!
唯有死者才得见愚蠢代际战争的终结。智商(英文 IQ)(以及围绕它的论调)不过是又一个战场。无论如何,我们要记住:拥有和牛顿一样的智商之所以听起来很美(祝你好运),唯一的原因是牛顿这辈子做了点有意思的事。要我说,还是把心思放在这上面吧。
同样的问题也可以拿来问大语言模型:它们是聪明,还是只是背下了数据?比如特德·姜(大名鼎鼎的科幻作家)就说,它们不过是一种数据压缩(就像 .zip 或 .rar),而且是有损压缩(lossy compression):他打了个比方,说大语言模型是互联网的一张模糊 .jpeg。那么,面对这些把人类所有数字化文字数据打成一杯奶昔喝下去的语言模型,我们该如何评估,才能断言它们不只是在反刍,而是能够达到真正的理解?这是价值千万亿美元的问题,而基准就是我们自己。
通用人工智能对应的是我们的自然通用智能。所以,我们得想清楚:我们凭什么说自己聪明,我们能做到什么,究竟是什么让我们彼此认为对方有智力,然后再尝试把这些想法推及语言模型。如果我们能设计出可以预测其在任何认知任务上都有良好整体表现的评估,我们就有理由相信它们是智能的。这意味着要设计一个名为“通用智能”的理论建构,一个关于我们认为智力是什么的模型,并搭建出任务(考试),用作语言模型的基准——如果大语言模型能解决它们,我们就有真正的理由说它们具备我们自以为在评估的那种东西(那个理论建构)。也就是那种让我们会说“它要是能搞定这个,我就把我的财务交给它”(或者把我的核武器交给它,如果你是美国或中国的话)的东西。
面对这些把人类所有数字化文字数据打成一杯奶昔喝下去的语言模型,我们该如何评估,才能断言它们不只是在反刍?这是价值千万亿美元的问题,而基准就是我们自己。
但事情没那么简单。如今,语言模型的设计需要基准来决定该朝哪些研究方向推进。如果我们无法知道新的语言模型架构是否比旧的更好,发明新架构就几乎无从下手。只是看起来更好是不够的。更糟的是,每一个公开的基准,我们都可以料定它会出现在后续模型的训练数据里,所以它被解出来能告诉我们的信息很有限:我们一发布基准(理想情况下它应该可重复且公平,而实现这一点的方法之一就是公开),Anthropic 或阿里巴巴的人就可以拿这个基准来训练模型,确保自家模型在基准上表现出色,却未必真的擅长这个基准本来想要测量的能力。
业界和公众都需要更好的评估,但这是一件吃力不讨好、昂贵又困难的工作,相信我。我们老师出考题的时候没人喜欢我们,语言模型的评估也差不多。设计这些机器比评估它们赚钱多了。而这还只是与我们有参照物的东西相关的问题:我们自身的能力,尽管我们无论在人身上还是机器身上都不太会测量它。真正的大问题是:硅谷那位“机器之神”的基准(一个或多个)会是什么样子?我们要怎么知道自己已经实现了人工超级智能?也许会像吉布森在他的一些小说里、或者斯派克·琼斯的电影《她》里所暗示的那样:我们根本察觉不到。它们会与我们擦肩而过,而我们会在不知不觉中失去对世界的认知主导权。又或者,这个问题本身就没那么好。
Y a cada colaborador se le paga por su trabajo. Las dos cosas dependen de los suscriptores.