ベンチマーキング:AIを評価するための競争
AIが本当に「考えて」いるのか、それともデータを吐き出しているだけなのか、どうすれば見分けられる? ごまかされずにデジタルな知性を評価するための科学。

AIが本当に「考えて」いるのか、それともデータを吐き出しているだけなのか、どうすれば見分けられる? ごまかされずにデジタルな知性を評価するための科学。

我に支点を与えよ、さらば世界を動かさん。――アルキメデス
人工知能開発全般の核心には軍拡競争がある。ただ、ここでは特に言語に応用されたAIに絞って話をしたい。AIシステムの開発が目指すのは、一連の能力の獲得だ。基本的には認知的な能力、人間的な、あるいは人間の役に立つ能力である。文章を書く、理解する、翻訳する、要約する、礼儀正しくふるまう、公正である、諜報報告書を作る、「我々はずっとユーラシアと戦争していた」と宣言する、人を欺く、反対派の身辺調査ファイルを作る、全面核戦争に勝つ、などなど。そのどれをとっても、システムがうまくやれているかどうかを評価する方法、とりわけ同じ目的で設計された他のシステムと比べてどうなのかを測る方法が必要になる。
これは、モデルを設計する(あるいは育てる)側にとっても、それを契約したり使ったりしたい側にとっても問題になる。人工知能システムを作る側は、狙うべき測定可能な目標を必要とする。モデルを契約したい、あるいは使おうか検討している側は、どれが一番いいのかを知りたい。でも、どうやって? まあ、ひとつのやり方はノリで決めることだ。言語モデルを使うとき誰もがやっていることの、ちょっと洗練されたバージョンである。使ってみる。こいつには解けないだろうと思う問題を出す。解いてしまう。あごが外れる。「うわ、マジでヤバくない?」と言う。でも多くの人が気づいているとおり、それはただのまぐれかもしれないし、まさにそのモデルが訓練されてきた種類の問題だったのかもしれない。そしてそれをうまくこなせたからといって、ほかのこともうまくこなせる保証にはならない。
人工知能システムを作る側は、狙うべき測定可能な目標を必要とする。モデルを契約したい、あるいは使おうか検討している側は、どれが一番いいのかを知りたい。でも、どうやって?
言語モデルの性能を評価するもう少し洗練されたやり方は、専門家にそのスキルや知識を直接評価させることだ。これは多少マシに機能するが、ずっと高くつくし、遅いし、それでも間違いはある。もうひとつのやり方は、モデル同士をノリで競わせることだ(chatbot arenaがイロレーティングでやっているように)。どれかを伏せたまま二つのモデルを出され、どっちが好きかを答える。とはいえ、これも基本的には目分量での評価と同じ問題を抱えている。単なる意見に依拠しているのだ。けっこうな手がかりにはなるが、十分ではない。四つ目のやり方は、モデルを脳の解剖のように真ん中から切り開いて、何が起きているかを見ることだ。これは「ホワイトボックス」分析(ブラックボックスの反対、つまり中身をのぞける箱)と呼ばれるが、モデルによってはほとんど情報が得られないか、あるいは遅すぎて現実的でないかのどちらかだ。そもそもOpenAIもAnthropicも、金のトークンを産むガチョウに触らせてくれるわけがない。残るは、標準化された試験を受けさせることだ。
「ベンチマーク」という言葉には多くの意味があって、何かの「テストベンチ」みたいなものの話に聞こえるが、それが語源ではない。語源がいつも重要なわけではないけれど、今回は問題を理解する助けになるかもしれない。英語の「benchmark」は測地学から来ている。地球を測量する学問で、地形測量士や土地測量士の仕事の土台になるものだ。都市には高低差があり、たとえば配管のルートを引いたりするときには、街の水の流れを考慮するために、さまざまな建造物の相対的な標高を把握しておく必要がある。
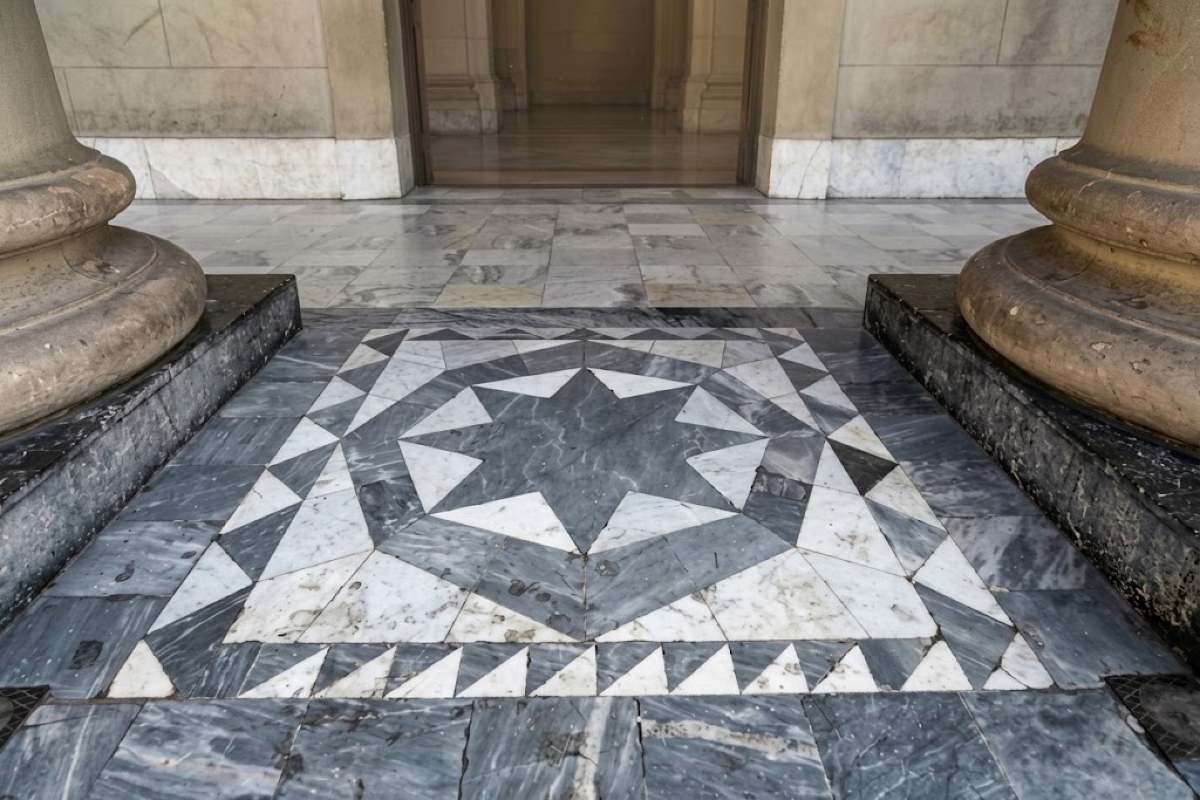
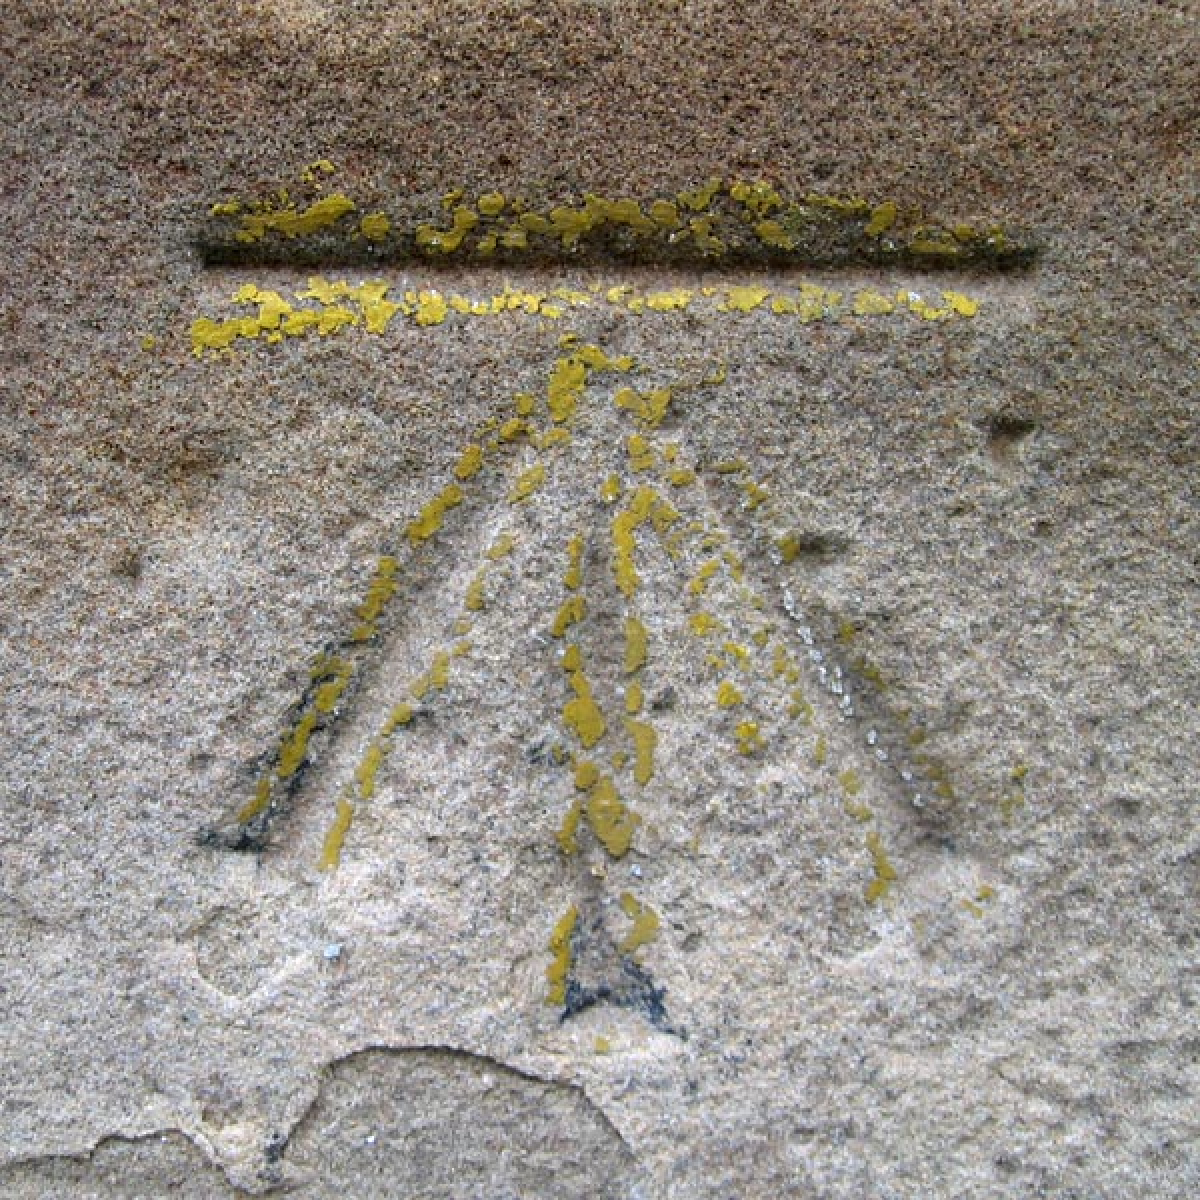
そのために、近代の都市(ここで近代というのは、だいたい18世紀以降のこと)の当局は、街のあちこちに測地学上の「固定点」(スペイン語では測地学的なベンチマークをこう呼ぶ。日本でいう水準点だ)を刻んでいった。都市には基準となる固定点、つまりゼロ地点があり、ブエノスアイレス自治市の場合は大聖堂の入り口にある。方位図の形をしている。首都のすべての測地固定点は、このゼロ地点に対する相対的な高さで記されている。
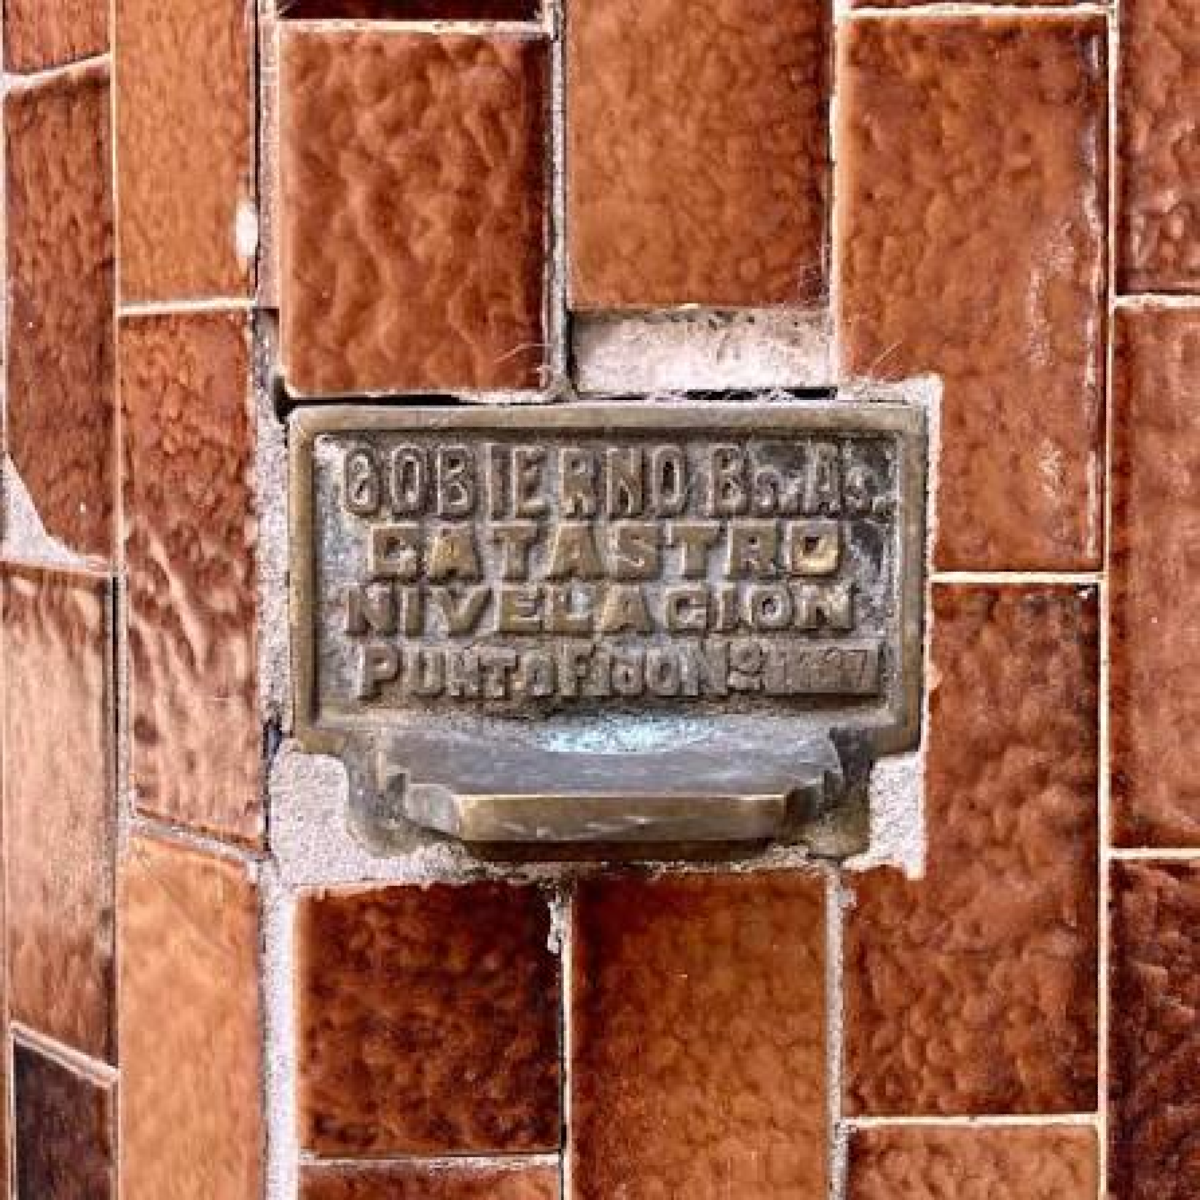
大聖堂にある、この街の基本となる固定点はこんな感じだ。
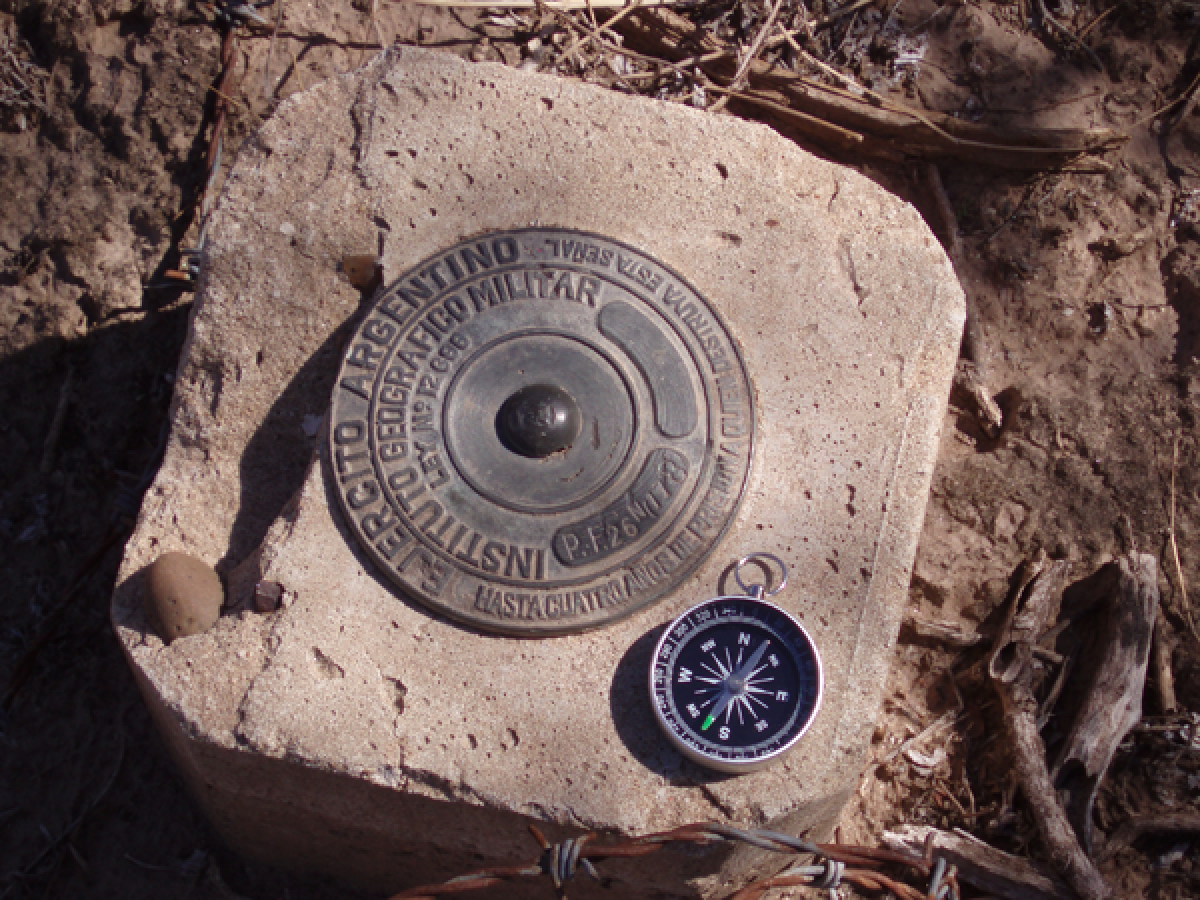
だが固定点は国中にあって、国立地理院(軍地理院の後身)が設置している。
これによって土地測量士、地形測量士、地図製作者、建築家、土木技師は、標高と地理的位置がマッピングされた相対的な基準点を仕事に使えるわけだ。今ではその多くがGPSで済まされているが、こんな重要な情報を衛星システムに全面依存するほど間抜けな国は(少なくとも今のところは)ない。壁に埋め込まれた鉄片と大量の台帳に勝るものはないのだ(Ruoccoならlow tech, high lifeと言うだろう)。
「ベンチマーキング」の本来の用法(石や花崗岩に水平の印[mark]を刻み、そこに水準器を当てて、標尺のための台、つまり据え台[bench]とするもの)を拡張して、さまざまな分野でこの言葉は、同じ種類の複数のものを比べるための(相対的な)性能テストを指すようになった。コンピューティングでは、俺たちゲーマーは特定のゲームや基準テストでシステムの性能を測るのにこれを使う。自分のマシンが他と比べてどれくらい優秀か、おおよその目安を教えてくれるものだ。
機械学習システムでよくあるやり方は、モデルを訓練するためのデータセット(データの集合)を用意し、それを訓練用80%、評価用20%に分けるというものだ。80%で訓練したモデルが、評価用データを一度も見ないまま、評価用データの予測で高い性能を出せたなら、そのモデルは訓練データで見たものから汎化した、ある意味で「学習した」と言える。そうでなければ、言えない。すでに見た問題しか解けないモデルなんて、何の役にも立たない。
実際にはこう考えればいい。訓練用データセットには、地理や代数や解析学の問題が山ほど、それぞれ選択肢と正解つきで入っている(文法問題でもいいし、マジック:ザ・ギャザリングのカードの知識問題でもいい)。評価用データセットには、訓練には出てこなかった問題が入っていて、その答えはモデルに見せず、評価のためにとっておく。選択肢を与えて(マークシート式の試験みたいに)、当たるかどうかを見る。正答率がそのデータセットにおける精度、つまりaccuracyであり、これをベンチマークとして使えるわけだ。
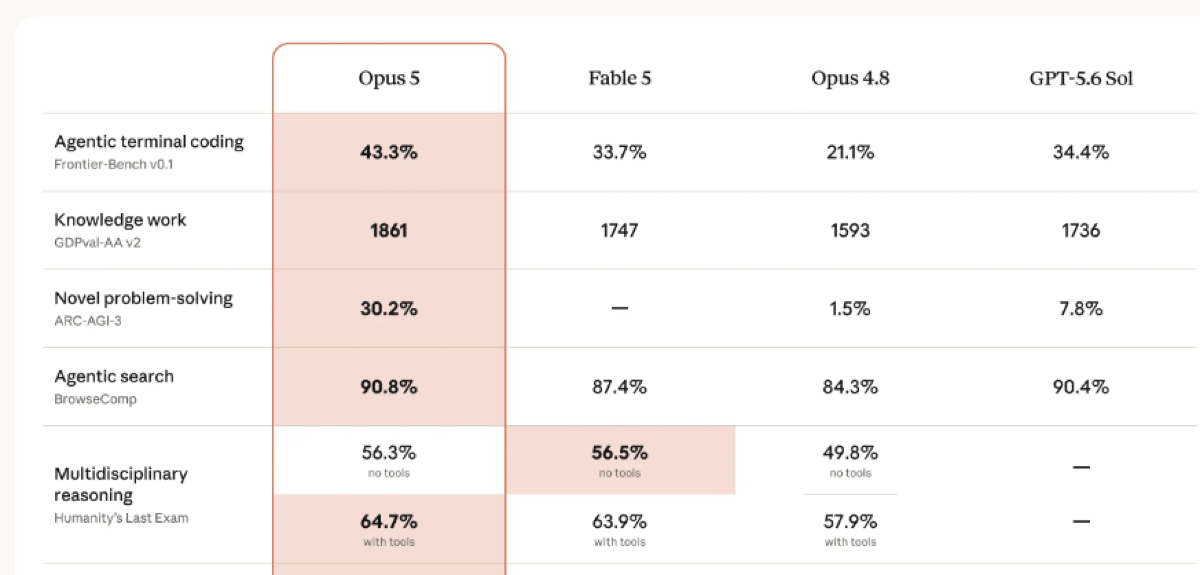
この意味で、多くの言語モデルに受けさせることのできる評価用データセット(訓練用データセットの一部であってもなくても)は、ベンチマーク
さて、グラフィック系のベンチマークで自分のマシンが何点を出したかは、それ自体が重要なのではなく、ゲームをしたり動画をレンダリングしたり、何であれ(ベンチマークではない)やりたいことに使ったとき自分のマシンに何ができるかの手がかりとして重要だ。言語モデルでも似たようなことが起きる。言語モデルがベンチマークで好成績なのが大事なのは、ベンチマークの点数それ自体に意味があるからではない。好成績であることが、そのモデルにできるベンチマーク以外のことについて何かを教えてくれるなら、そのときに限って好成績であってほしいのだ。
言語モデルがベンチマークで好成績なのが大事なのは、その点数それ自体に意味があるからではない。好成績であることが、そのモデルにできるベンチマーク以外のことについて何かを教えてくれるなら、そのときに限って好成績であってほしいのだ。
これは、俺たち教師が試験をするときにやっていることとよく似ている。評価の道具はそれ自体が重要なわけではない。多くの高校生(そして多くの大学生)は、教師が課すレポートや書かせる小論文を、教師が読んで何かを得るための依頼、まるで教師がそこから何かを学ぶかのような依頼だという(誤った)考えのもとで動いていることがある。まるでレポートが、企業がコンサルに発注する報告書か何かであるかのように。教師が生徒から学ぶことがないと言いたいわけではない(しょっちゅう学んでいる)。でも、それが生徒に評価を課す理由ではない。
評価の役割のひとつは診断だ(ほかにも、たとえば形成的な役割がある。目標とするスキルを鍛えていくために、頭をひねって苦しんでほしいというやつだ)。君がどんな調子かを知って、いずれ職業生活で似たような問題を解くときにどうなりそうか、ある程度見当をつけたいのだ(たとえば大学レベルなら)。つまり、人間に課す試験はしばしば、ある人に能力――似たような問題を解く傾向性として理解されるもの――を帰属させる根拠を得るための道具なのである。誰かと知り合い、何度か嘘をつかれるのを目にし、それを十分な根拠としてその人に嘘つきという性質を帰属させる。その洗練された親戚のようなものだ。嘘つきのレッテルを貼られるのは危険だ(オオカミ少年の話のように)。人はこの先も嘘をつくだろうという前提で君を扱うし、そう扱われたら、もう真剣に相手にしてもらえない(一種の社会的な死だ)。一方、弁護士というレッテルを貼られるのは、学部の教授全員とのラウンドに勝ち抜いたということであり(ポケモンのジムリーダーたちを倒したサトシのごとく)、この先もそれを続けられるはずだと見なされるということだ。
さて、運転免許試験が単なる許可ではなく、能力の帰属とそれに伴う責任にもとづいた許可であるように(うまく運転できるなら、下手な運転をしたときの責任は君にある)、もっと抽象的な能力についても同じことが言える。たとえば認知能力だ。心理測定学者たちはずいぶん前から、より抽象的な能力を評価する方法を設計しようとしてきた。そこには究極の能力、能力の中の能力、人間のスキル免許の聖杯、すなわち知能も含まれる。
人工知能の専門家François Chollet(ARC-AGI ベンチマークの生みの親)の言葉を借りれば、あるタスクを解決する能力は君がどれだけ熟練しているかを示し、知能は新しいタスクを解くための新しい能力をどれだけ効率よく(たとえば速く)身につけられるかを測るものだ。つまり、誰かを頭がいいと言うとき、その人が何か特定のことができると言っているわけではない。やる気と機会と時間さえあれば、そのスキルに熟達するのに他の人より時間も労力もかからないだろう、と言っているだけなのだ(だからこそ、本人から見ても他人から見ても何の役にも立たない頭のいい人がこんなにたくさんいることと、つじつまが合う)。
このように、知能は直接測ることができない。なぜなら、あなたの能力の多くは、心理測定学者が「結晶性知能」(結晶性g因子、Gc)と呼ぶもので、「流動性知能」(Gf)とは別物かもしれないからだ。認知能力の測定を専門とする心理学者たちは、結晶性知能にはあまり関心がない。何かについてよく知っているのにバカ、ということがありうるからだ(この人たちに言わせれば、の話で、私を責めないでほしい)。「idiot savant」(白痴の天才)とは、データは覚えているのに、暗記したデータの先へは推論を進められない人物像のことだ。これを誰よりも見事に描いているのは、もしかするとボルヘスの「記憶の人、フネス」かもしれない。
こうしたテストは、あなたの知能を直接測っているわけではない(そんなことはどうも不可能らしい)。測っているのは、あなたの結果がどの年齢別の平均点に近いか、だ。自分の実年齢より上の年齢の平均に近い点数を取れば、同年代の人たちより認知的スキルを身につけるのが効率的だということになる。一致する平均点の年齢が上がれば上がるほど、指数も大きくなる:(精神年齢/実年齢)×100=IQ。
IQが高いと自慢したがる20歳の若者たちへの注意書き:それはつまり、せいぜい30歳の平均点が取れるという意味でしかない(精神年齢36の18歳ならIQ200で、これが測定可能な上限。IQ130というのは、18歳でIQテストを24歳並みにこなすということ……)。君たちがバカにしてる、まさにその連中と同じ点数ってわけだ。30歳の男でIQが高いというのは、40歳を迎える前に、自分が人生で何をやってるのかわからなくて悶々とし、パートナーに去られ、ハーレーダビッドソン(親の遺産がないなら、GTA VIをやるためのプレイステーション)を買える、というだけの話だ。おめでとう!
くだらない世代間戦争の終わりを見たのは死者だけだ。IQ(をめぐる言説)は、その戦場のひとつにすぎない。いずれにせよ、ニュートンと同じIQを持っているのが素敵に聞こえる唯一の理由は(まあ、頑張って)、ニュートンが人生で何か面白いことを成し遂げたからだ、ということを思い出しておこう。私ならそっちに集中する。
同じ問いはLLMにも向けられる。LLMは知的なのか、それともデータを暗記しただけなのか?テッド・チャン(あの超有名なSF作家)は、たとえば、LLMは一種のデータ圧縮(.zipや.rarのような)にすぎないと言う。それも非可逆圧縮(lossy compression)だ。彼はLLMを「インターネットのぼやけた.jpeg」にたとえた。では、人類がデジタル化したあらゆる文字データをミキサーにかけて飲み干した言語モデルが、ただ吐き戻しているだけではなく、本当の理解に到達しうると主張するには、それをどう評価すればいいのか?それこそが千兆ドルの問いであり、ベンチマークは私たち自身なのだ。
汎用人工知能は、私たちの自然な汎用知能に対応するものだ。だから、私たちはどうやって自分たちが知的だと主張できるのか、何ができるのか、何をもって私たちは本当に互いに知性を認め合っているのかを考え、その考えを言語モデルに外挿しようとしなければならない。どんな認知タスクでも全般的に良い成績を予測できるような評価を設計できれば、LLMは知的だと信じる理由が手に入る。つまり、「汎用知能」という理論的構成概念、すなわち私たちが知能とはこういうものだと考えているモデルを設計し、言語モデルのベンチマークとして使うタスク(試験)を組み立てなければならない。LLMがそれを解いたなら、私たちが評価しているつもりのもの(理論的構成概念)をLLMが持っていると言える本物の理由になるような、そんなタスクだ。「これが解けるなら資産運用を任せる」(アメリカや中国なら核兵器を任せる)と言えるような類のものだ。
人類がデジタル化したあらゆる文字データをミキサーにかけて飲み干した言語モデルが、ただ吐き戻しているだけではないと主張するには、それをどう評価すればいいのか?それこそが千兆ドルの問いであり、ベンチマークは私たち自身なのだ。
だが、そう簡単な話ではない。今日、言語モデルの設計には、どの研究の方向を追うべきかを見極めるためのベンチマークが欠かせない。新しいアーキテクチャが従来のものより優れているかどうかがわからなければ、新しいアーキテクチャを発明しても拠り所がほとんどない。優れているように見えるだけでは足りないのだ。さらに悪いことに、公開されたベンチマークはどれも、次のモデルの学習データに紛れ込むと思っておいたほうがいい。だから、それが解けたことから得られる情報は限られている。ベンチマークを公開すると(ベンチマークは再現可能で公平であるべきで、そのための方法のひとつが公開することだ)、AnthropicやAlibabaの人たちは、そのベンチマークでモデルを訓練して、ベンチマークで抜群の成績を取るように仕上げられる。ベンチマークが本来測ろうとしていた能力そのものに長けているとは限らないのに、だ。
業界も一般の人々もより良い評価を必要としているが、それは報われず、金がかかり、難しい仕事だ。信じてほしい。試験をする教師を好きな人なんていないし、言語モデルの評価だって事情はたいして変わらない。こうした機械は、評価するより設計するほうがずっと金になる。しかもこれは、まだ参照できるもの、つまり私たち自身の能力に関わる問題にすぎない。人間でも機械でも、それをうまく測れているわけではないにしても。大きな問いはこうだ。シリコンバレーの「機械の中の神」のためのベンチマーク(ひとつか、複数か)は、どんな姿をしているのだろう?私たちが人工超知能に到達したと、どうやって知ればいいのだろう?もしかすると、ギブスンがいくつかの小説で、あるいはスパイク・ジョーンズの映画『her/世界でひとつの彼女』がほのめかしているようなことが起きるのかもしれない。つまり、私たちは気づきもしない。あっさり追い越され、知らないうちに世界の認知的な支配権を失っているのだ。あるいは、そもそもこれはたいして良い問いではないのかもしれない。
Y a cada colaborador se le paga por su trabajo. Las dos cosas dependen de los suscriptores.