Benchmarking: a corrida para avaliar a inteligência artificial
Como saber se uma IA "reflete" ou só regurgita dados? A ciência de avaliar mentes digitais sem cair no engano.

Como saber se uma IA "reflete" ou só regurgita dados? A ciência de avaliar mentes digitais sem cair no engano.

Dê-me um ponto fixo e moverei o mundo. - Arquimedes
Existe uma corrida armamentista no coração do desenvolvimento de inteligências artificiais em geral, mas vou me concentrar nas aplicadas à linguagem em particular. O desenvolvimento de um sistema de IA busca alcançar uma série de capacidades, em princípio cognitivas, humanas ou úteis aos humanos. Seja redigir textos, compreender, traduzir, resumir, ser educado, ser justo, produzir relatórios de inteligência, declarar que sempre estivemos em guerra com a Eurásia, enganar, montar dossiês sobre opositores, vencer guerras termonucleares etc. Para qualquer uma dessas tarefas, precisa existir uma maneira de avaliar se o sistema faz isso bem ou mal e, em particular, como ele se compara com outros sistemas projetados com o mesmo objetivo.
Esse é um problema que afeta tanto quem projeta (ou cultiva) os modelos quanto quem gostaria de contratá-los ou usá-los. Quem cria sistemas de inteligência artificial precisa de objetivos mensuráveis para mirar; quem quer contratar modelos ou pensa em usá-los quer saber qual é o melhor. Mas como se faz isso? Bom, uma forma é fazer na base das vibes, que é a variante sofisticada do que todo mundo faz ao usar um modelo de linguagem. Você usa, dá a ele um problema que acha que ele não vai conseguir resolver, ele resolve, seu queixo cai e você diz "caramba, você não tem noção". Mas, como muitos de nós já percebemos, isso pode ser sorte, ou justamente o tipo de problema para o qual o modelo foi treinado, e o fato de ele ter feito bem isso não garante que ele consiga fazer bem outras coisas.
Quem cria sistemas de inteligência artificial precisa de objetivos mensuráveis para mirar; quem quer contratar modelos ou pensa em usá-los quer saber qual é o melhor. Mas como se faz isso?
Uma forma mais sofisticada de avaliar o desempenho de modelos de linguagem é colocar especialistas para avaliá-los diretamente quanto às suas habilidades/conhecimentos. Isso funciona um pouco melhor, mas é muito mais caro, lento e ainda falível. Outra forma consiste em fazer os modelos competirem na base das vibes, entre si (como fazem na chatbot arena, com rankings ELO): te dão dois modelos sem dizer quais são e você diz de qual gosta mais. No entanto, isso tem basicamente os mesmos problemas de avaliar no olho: se apoia em meras opiniões. Te dá bastante, mas não o suficiente. Uma quarta forma é pegar um modelo e abri-lo ao meio, como se você dissecasse um cérebro, e ver o que acontece. Essas são análises de "caixa branca" (o contrário de uma caixa-preta, uma caixa em que dá para olhar o que tem dentro) que ou são pouco informativas para certos modelos, ou lentas e impraticáveis demais. Sem contar que nem a OpenAI nem a Anthropic vão te dar acesso à sua galinha dos tokens de ouro. Resta aplicar provas padronizadas a eles.
A palavra "benchmark" tem muitos sentidos e soa como se estivéssemos falando de algum tipo de "banco de testes" ou algo do gênero, mas não é essa a sua origem. A etimologia nem sempre é relevante, mas neste caso pode ajudar a entender a questão. A palavra inglesa "benchmark" vem da geodésia, a disciplina que se encarrega de fazer medições da Terra e que serve de insumo para topógrafos e agrimensores. As cidades têm diferentes alturas, o que exige levar em conta a elevação relativa de diferentes construções, por exemplo para traçar encanamentos e coisas do tipo, para considerar o escoamento da água numa cidade.
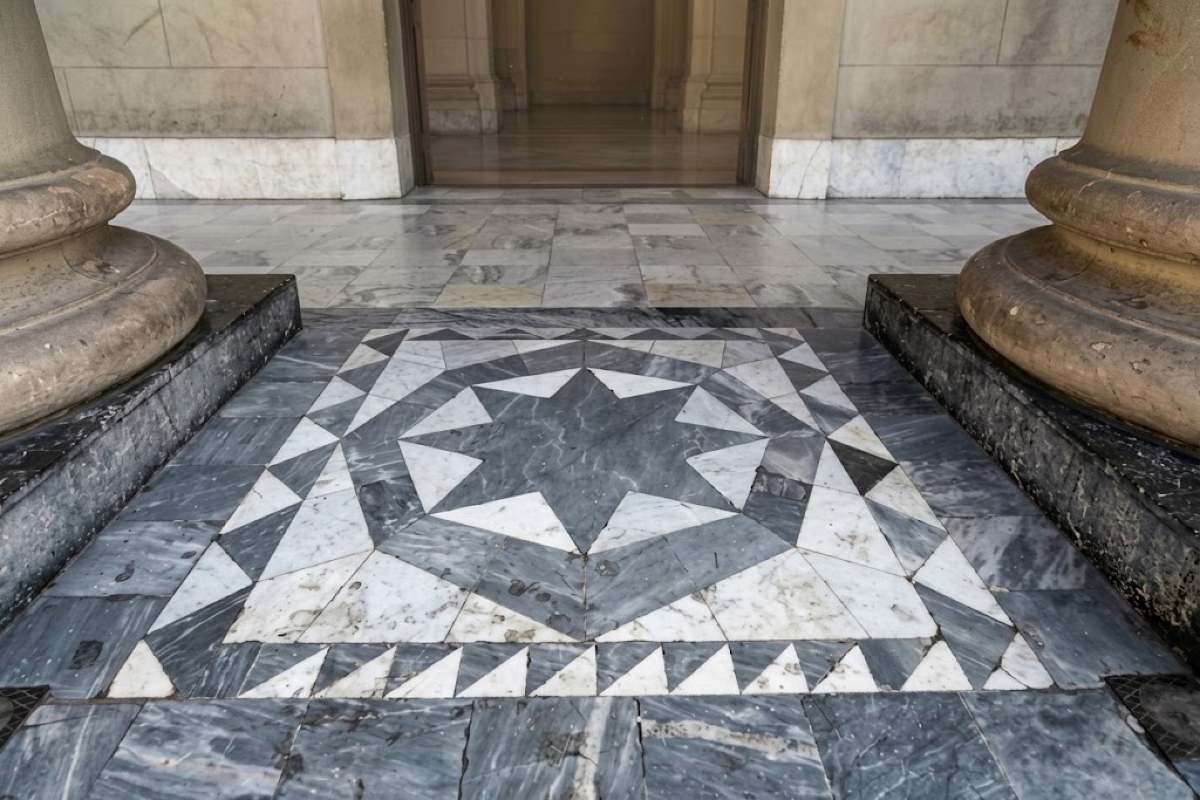
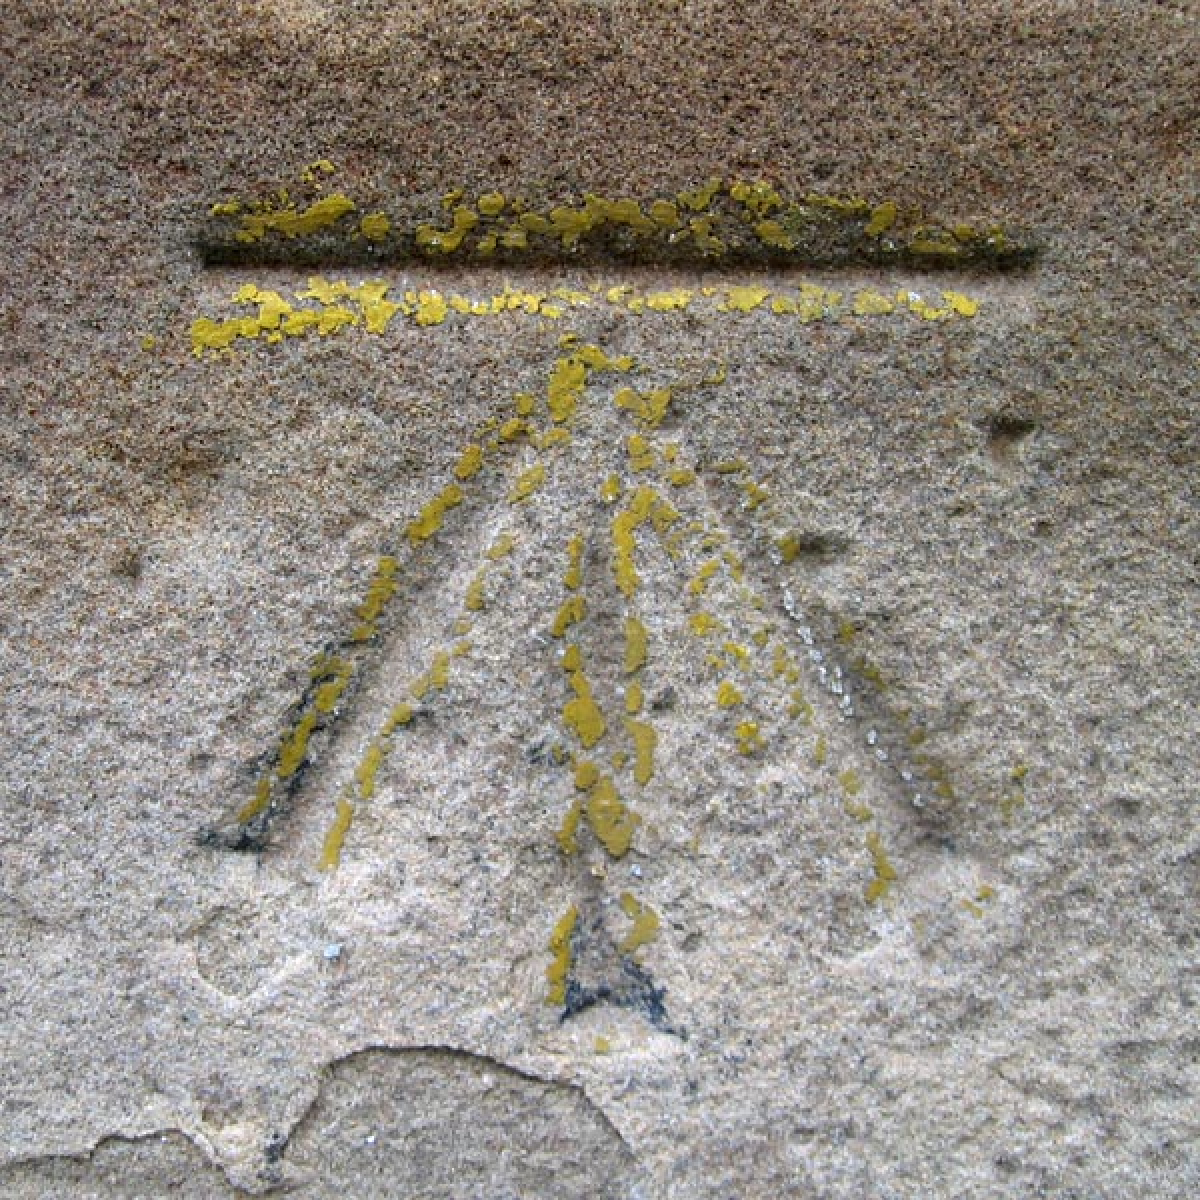
Para isso, as autoridades das cidades modernas (e por modernas quero dizer do século XVIII para cá, aproximadamente) se encarregaram de marcar "pontos fixos" geodésicos (como chamamos os benchmarks geodésicos em espanhol) em diferentes partes da cidade. As cidades têm um ponto fixo de referência, ou ponto zero, que na Cidade Autônoma de Buenos Aires fica na entrada da Catedral. É uma rosa dos ventos. Todos os pontos fixos geodésicos da capital estão marcados numa altura relativa a esse ponto zero.
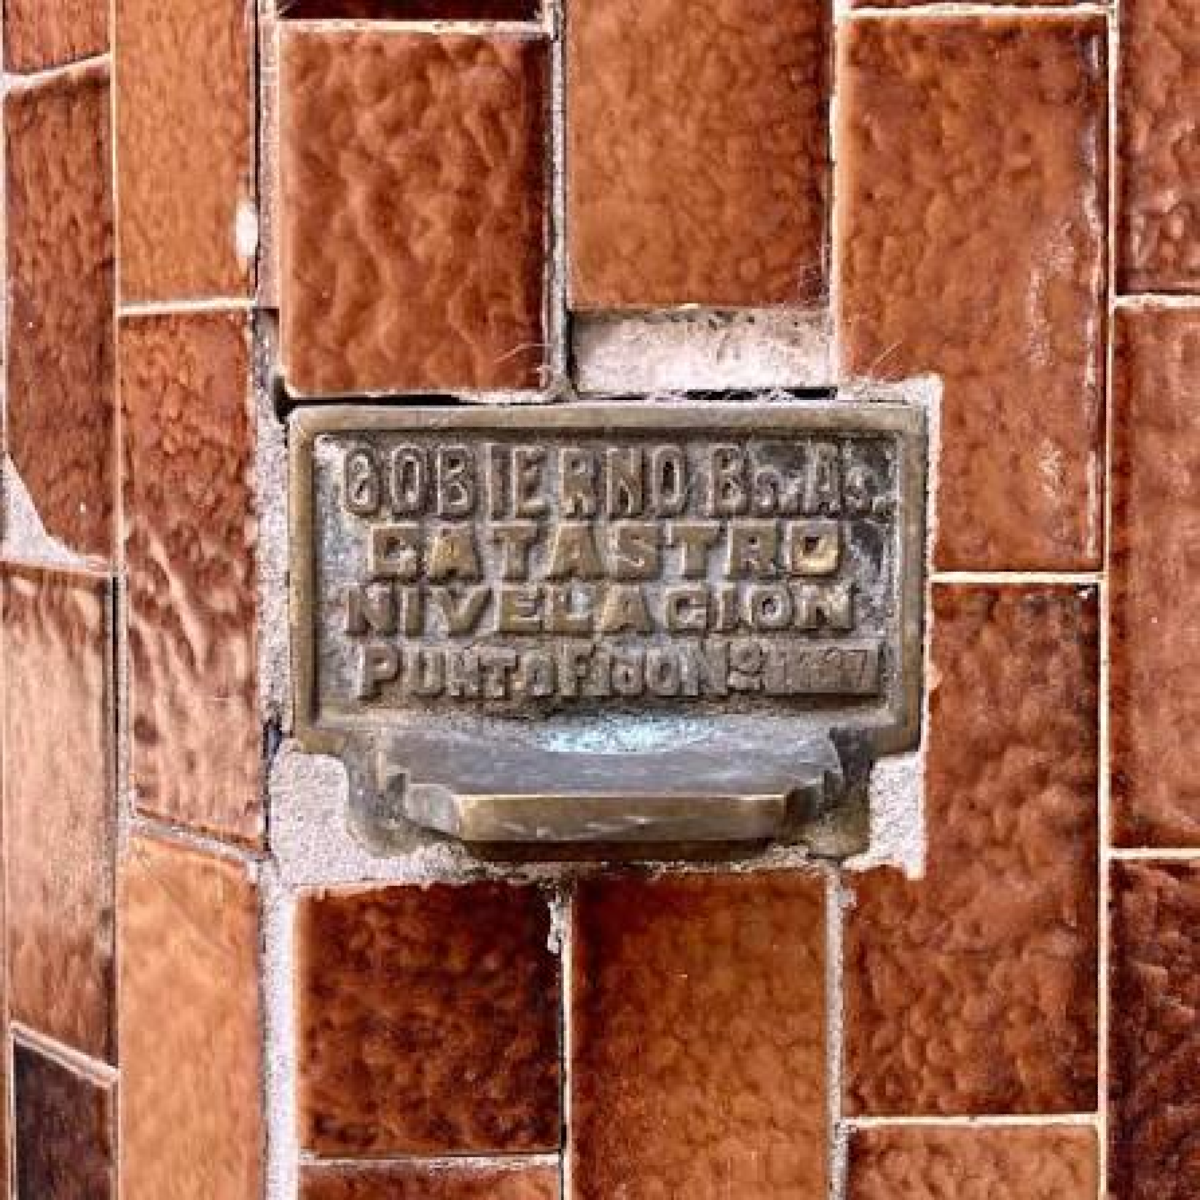
O ponto fixo fundamental da cidade, o que fica na Catedral, é assim:
Mas há pontos fixos em todo o país, instalados pelo Instituto Geográfico Nacional (sucessor do Instituto Geográfico Militar):
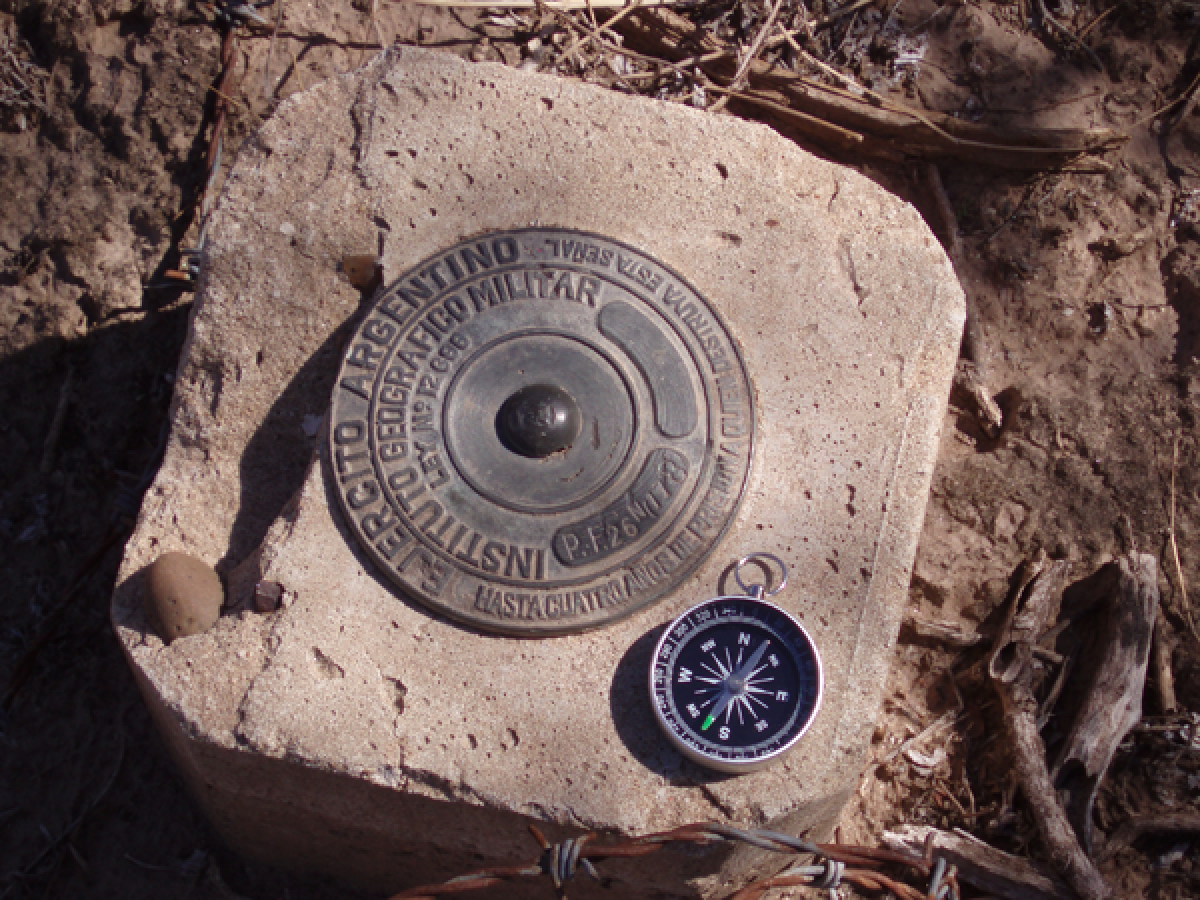
Isso permite que agrimensores, topógrafos, cartógrafos, arquitetos e engenheiros civis tenham pontos relativos de referência para seus trabalhos, mapeados com altura e posição geográfica. Hoje em dia muito disso é feito com GPS, mas nenhum país é tão idiota (ainda, pelo menos) a ponto de depender inteiramente de um sistema de satélites para essa informação crucial. Nada supera um pedaço de ferro cravado numa parede e muitas planilhas (low tech, high life, diria Ruocco).
Como uma extrapolação do uso original do "benchmarking" (fazer marcas [mark] horizontais em pedra ou granito sobre as quais apoiar um nível e formar um banco ou assento ["bench"] para uma mira de nivelamento), em diferentes áreas o termo é usado para se referir a um teste de desempenho (relativo) a partir do qual comparar várias coisas do mesmo tipo. Na computação, nós, gamers, usamos benchmarks para rodar testes de desempenho do nosso sistema em certos jogos ou testes de referência que nos dão uma indicação aproximada de quão boa é a nossa máquina em comparação com outras.
Uma prática comum em sistemas de aprendizado de máquina é ter um dataset (um conjunto de dados) sobre o qual treinar o modelo e dividi-lo em 80% para treinamento e 20% para avaliação. Se o modelo treinado com os 80%, sem nunca ver o conjunto de dados de avaliação, tem um desempenho alto ao prever os dados do conjunto de avaliação, dá para dizer que o modelo generalizou a partir dos dados vistos no conjunto de treinamento e, em algum sentido, "aprendeu". Caso contrário, não. Um modelo que só consegue resolver problemas que já viu não serve para nada.
Na prática, podemos pensar assim: no conjunto de dados de treinamento temos um monte de problemas de geografia, álgebra ou cálculo, uma série de respostas possíveis e a resposta correta (podem ser problemas gramaticais, ou de conhecimento sobre cartas de Magic). No conjunto de dados de avaliação temos problemas que não apareceram no treinamento e não mostramos a resposta ao modelo, guardamos para avaliá-lo. Damos a ele uma série de opções (tipo prova de múltipla escolha) e vemos se ele acerta. A taxa de acertos nos dá sua precisão, ou accuracy, no dataset, que podemos tomar como um benchmark.
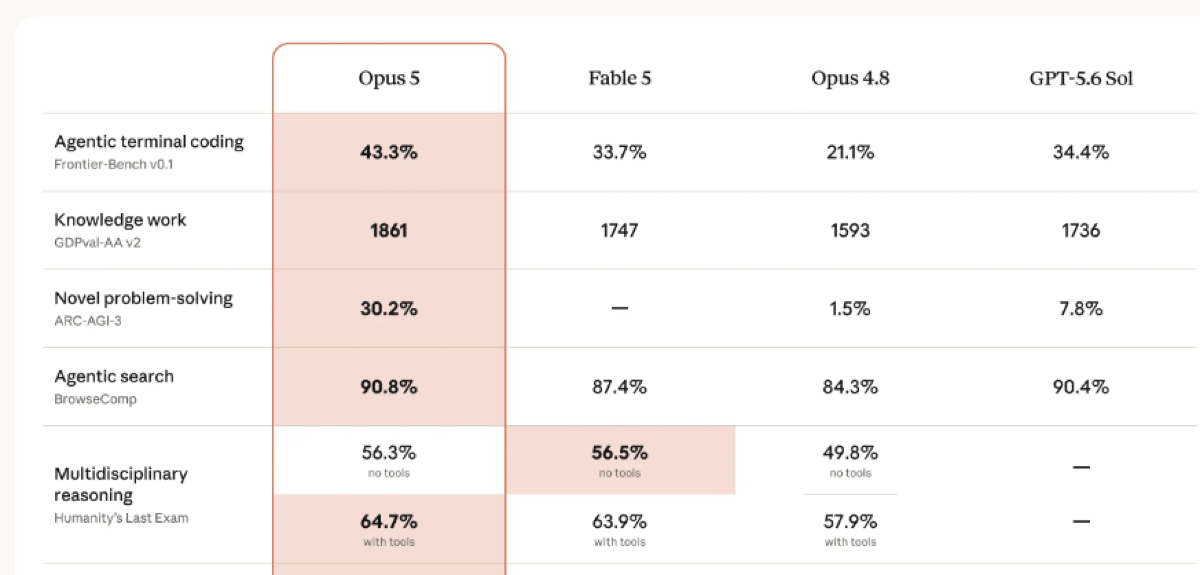
Nesse sentido, um conjunto de dados de avaliação (faça ele parte de um conjunto de dados de treinamento ou não) que possa ser aplicado a muitos modelos de linguagem cumpre o papel de um benchmark.
Agora, assim como o fato de a sua máquina ter determinada pontuação num benchmark gráfico não é importante em si mesmo, mas como indício do que a sua máquina consegue fazer quando você a usar para jogar, renderizar vídeos ou o que quer que você queira fazer (que não é o benchmark). Com os modelos de linguagem acontece algo parecido. Você não se importa que um modelo de linguagem seja bom no benchmark porque isso signifique algo em si mesmo; você se importa que ele vá bem se o fato de ele ir bem te diz algo sobre o que ele consegue fazer que não é o benchmark.
Você não se importa que um modelo de linguagem seja bom no benchmark porque isso signifique algo em si mesmo; você se importa que ele vá bem se o fato de ele ir bem te diz algo sobre o que ele consegue fazer que não é o benchmark.
Isso é muito parecido com o que nós, professores, fazemos ao aplicar uma prova. Os instrumentos de avaliação não importam em si mesmos. Muitos alunos do ensino médio (e muitos universitários) às vezes agem sob a ideia (errada) de que os trabalhos que os professores passam, ou as redações que escrevem, são algum tipo de encomenda que o professor vai ganhar algo lendo, como se o professor fosse aprender alguma coisa. Como se o trabalho fosse algum tipo de relatório que uma empresa encomenda a uma consultoria. Não quero dizer que nós, professores, não possamos aprender com nossos alunos (fazemos isso o tempo todo), mas não é esse o motivo de submetê-los a avaliações.
Um dos papéis das avaliações é o diagnóstico (existem outros, como um papel formativo: quero que você quebre a cabeça para ir forjando a habilidade-alvo envolvida): quero saber como você está indo para, eventualmente, ter alguma ideia de como você se sairia resolvendo problemas parecidos na sua vida profissional (no nível universitário, por exemplo). Ou seja: as provas aplicadas a humanos muitas vezes são instrumentos para termos razões para atribuir a uma pessoa uma competência, entendida como uma disposição para resolver problemas parecidos. Uma espécie de parente sofisticado de conhecer alguém, ver que a pessoa mente para nós várias vezes e considerar isso razão suficiente para atribuir a ela a propriedade de ser mentirosa. Ser rotulado de mentiroso é um perigo (como na história do pastorzinho e do lobo), porque as pessoas te tratam como se você fosse continuar mentindo e, se te tratam assim, deixam de te levar a sério (é uma espécie particular de morte social). Já ser rotulado de advogado significa que você venceu uma rodada contra todos os professores do curso (feito o Ash contra os mestres Pokémon), e supõe-se que você vai conseguir continuar fazendo isso no futuro.
Bom, assim como o exame de direção não é meramente uma permissão, mas uma permissão baseada numa atribuição de competência e na responsabilidade que vem junto (se você é capaz de dirigir bem, é responsável por dirigir mal), o mesmo acontece com competências mais abstratas. As capacidades cognitivas, por exemplo. Os psicometristas vêm há um bom tempo tentando criar formas de avaliar competências mais abstratas, incluindo a competência das competências, o Santo Graal das permissões de habilidade humanas: a inteligência.
Nas palavras do especialista em Inteligência Artificial François Chollet (criador do benchmark ARC-AGI), a sua capacidade de resolver uma tarefa diz o quão habilidoso você é, e a inteligência mede o quão eficiente (rápido, por exemplo) você é para adquirir novas capacidades para resolver tarefas novas. Ou seja, quando afirmamos que alguém é inteligente, não estamos dizendo que a pessoa seja capaz de fazer algo em particular, só que, se tivesse vontade, oportunidade e tempo, levaria menos tempo ou faria menos esforço do que outras pessoas para se tornar habilidosa na habilidade em questão (é assim que conseguimos conciliar o fato de haver tanta gente inteligente que não serve para nada, aos olhos de si mesma ou dos outros).
Assim, a inteligência não pode ser medida diretamente, porque boa parte da sua competência pode ser o que os psicometristas chamam de "inteligência cristalizada" (ou fator g cristalizado Gc) versus "inteligência fluida" (ou Gf). A inteligência cristalizada não interessa tanto aos psicólogos especialistas em medir habilidades cognitivas porque é possível saber muito sobre algo e ser um idiota (segundo essa gente, não me culpem). A figura do "idiot savant" (gênio idiota) é a de alguém que lembra dados, mas é incapaz de raciocinar além do que memorizou. Talvez "Funes, o memorioso", de Borges, ilustre isso melhor do que ninguém.
Esses testes não estão medindo diretamente a sua inteligência (isso não parece ser possível), estão medindo com qual resultado médio por idade o seu resultado se parece. Se você tira uma nota parecida com a de uma idade maior que a sua, isso significaria que você é mais eficiente em adquirir habilidades cognitivas do que as pessoas da sua idade. Quanto maior a idade cuja pontuação média coincide com a sua, maior vai ser o quociente: (IdadeMental/Idade)*100 = QI.
Aviso para os jovens de 20 anos que se acham por ter QI alto: significa que vocês tiram a nota média de gente de 30 anos, com muita sorte (alguém de 18 com idade mental de 36 teria 200 pontos de QI, o limite mensurável; 130 pontos é ter 18 e se sair nos testes de QI como alguém de 24...), os mesmos de quem vocês vivem tirando sarro. Ter QI alto aos 30 sendo homem só significa que você pode entrar em crise por não saber o que está fazendo da vida, levar um pé na bunda, comprar uma Harley Davidson (ou um PlayStation para jogar GTA VI, se você não for herdeiro) antes de chegar aos 40. Parabéns!
Só os mortos viram o fim das guerras intergeracionais estúpidas. O (discurso sobre o) QI (IQ em inglês) é só mais um de seus campos de batalha. De qualquer forma, lembremos que a única razão pela qual soa bonito ter o mesmo QI que Newton (boa sorte com isso) é que Newton fez algo interessante da vida. Eu focaria nisso.
A mesma pergunta pode ser feita sobre os LLMs: eles são inteligentes ou memorizaram dados? Ted Chiang (o famosíssimo escritor de ficção científica), por exemplo, diz que eles são meramente um tipo de compressão de dados (como um .zip ou .rar). Um tipo de compressão com perdas (lossy compression): ele usou a imagem de que os LLMs são um .jpeg borrado da internet. Então, como avaliamos modelos de linguagem que tomaram uma vitamina de todos os dados escritos digitalizados pela humanidade para afirmar que eles não estão meramente regurgitando e que podem alcançar uma compreensão verdadeira? Essa é a pergunta de mil trilhões de dólares, e o benchmark somos nós.
A Inteligência Artificial Geral é o correlato da nossa inteligência geral natural. Então é preciso pensar em como podemos afirmar que somos inteligentes, do que somos capazes, o que realmente faz com que atribuamos inteligência uns aos outros, para tentar extrapolar essas ideias para os modelos de linguagem. Se conseguirmos projetar avaliações que prevejam um bom desempenho geral em qualquer tarefa cognitiva, vamos ter motivos para acreditar que eles são inteligentes. Isso significa que é preciso projetar um constructo teórico chamado "inteligência geral", um modelo do que pensamos que é a inteligência, e montar tarefas (provas) para usar como benchmarks em modelos de linguagem que, se os LLMs as resolvessem, nos dariam motivos reais para dizer que eles têm aquilo que supomos estar avaliando (o constructo teórico). O tipo de coisa sobre a qual diríamos "se consegue resolver isso, entrego minhas finanças" (ou minhas armas nucleares, se você for os EUA ou a China).
Como avaliamos modelos de linguagem que tomaram uma vitamina de todos os dados escritos digitalizados pela humanidade para afirmar que eles não estão meramente regurgitando? Essa é a pergunta de mil trilhões de dólares, e o benchmark somos nós.
Mas não é tão fácil. Hoje em dia, o desenvolvimento de modelos de linguagem precisa de benchmarks para saber que direções de pesquisa seguir. Inventar novas arquiteturas de modelos de linguagem tem pouco em que se apoiar se não conseguimos saber se essas novas arquiteturas são melhores que as anteriores. Que pareçam melhores não basta. Pior ainda: podemos dar como certo que todo benchmark que se torna público vai aparecer nos dados de treinamento dos modelos seguintes, então a informação que a sua resolução nos dá é limitada. Depois que publicamos um benchmark (a ideia é que seja replicável e justo, e uma maneira de garantir isso é que seja público), a Anthropic ou o pessoal da Alibaba podem treinar o modelo no benchmark, garantindo que o modelo seja excelente no benchmark sem necessariamente ser bom na habilidade que o benchmark foi pensado para medir.
A indústria e o público precisam de avaliações melhores, mas é uma tarefa ingrata, cara e difícil, acreditem. Ninguém gosta dos professores quando aplicamos provas, e não é muito diferente com as avaliações de modelos de linguagem. Há muito mais dinheiro em projetar essas máquinas do que em avaliá-las. E esse é só o problema ligado a algo de que temos referência: as nossas capacidades, mesmo que não saibamos medi-las bem nem em pessoas nem em máquinas. A grande pergunta é: como seria o (ou os) benchmark para o Deus-na-máquina do Vale do Silício? Como saberíamos que alcançamos uma superinteligência artificial? Talvez acontecesse o que Gibson deixa entrever em alguns de seus romances ou o filme Ela, de Spike Jonze: a gente nem perceberia. Elas passariam direto por nós, e teríamos perdido o domínio cognitivo do mundo sem saber. Ou talvez a pergunta não seja tão boa assim.
Y a cada colaborador se le paga por su trabajo. Las dos cosas dependen de los suscriptores.