Benchmarking : la course pour évaluer l'intelligence artificielle
Comment savoir si une IA « réfléchit » ou se contente de régurgiter des données ? La science d'évaluer des esprits numériques sans tomber dans le piège.

Comment savoir si une IA « réfléchit » ou se contente de régurgiter des données ? La science d'évaluer des esprits numériques sans tomber dans le piège.

Donnez-moi un point fixe et je soulèverai le monde. - Archimède
Il existe une course aux armements au cœur du développement des intelligences artificielles en général, mais je vais me concentrer en particulier sur celles qui s'appliquent au langage. Le développement d'un système d'IA vise à atteindre une série de capacités, en principe cognitives, humaines ou utiles aux humains. Que ce soit rédiger du texte, comprendre, traduire, résumer, être poli, être juste, produire des rapports de renseignement, déclarer que nous avons toujours été en guerre avec l'Eurasie, tromper, ficher les opposants, gagner des guerres thermonucléaires, etc. Pour chacune de ces tâches, il doit exister une manière d'évaluer si le système s'en sort bien ou mal et, en particulier, comment il se compare à d'autres systèmes conçus dans le même but.
C'est un problème qui concerne aussi bien ceux qui conçoivent (ou cultivent) les modèles que ceux qui voudraient les acheter ou les utiliser. Ceux qui créent des systèmes d'intelligence artificielle ont besoin d'objectifs mesurables à viser ; ceux qui veulent acheter des modèles ou envisagent de s'en servir veulent savoir lequel est le meilleur. Mais comment on fait ? Eh bien, une façon de faire, c'est aux vibes, la variante sophistiquée de ce que fait tout le monde en utilisant un modèle de langage. Tu l'utilises, tu lui donnes un problème que tu crois qu'il ne pourra pas résoudre, il le résout, ta mâchoire tombe par terre et tu te dis « putain, t'imagines même pas ». Mais comme beaucoup d'entre nous s'en sont rendu compte, ça peut être un coup de chance, ou précisément le genre de problèmes pour lesquels le modèle a été entraîné, et le fait qu'il ait bien fait ça ne te garantit pas qu'il saura bien faire d'autres choses.
Ceux qui créent des systèmes d'intelligence artificielle ont besoin d'objectifs mesurables à viser ; ceux qui veulent acheter des modèles ou envisagent de s'en servir veulent savoir lequel est le meilleur. Mais comment on fait ?
Une façon plus sophistiquée d'évaluer les performances des modèles de langage consiste à demander à des experts de les évaluer directement sur leurs compétences/connaissances. Ça marche un peu mieux, mais c'est beaucoup plus cher, plus lent et toujours faillible. Une autre façon consiste à faire s'affronter les modèles aux vibes, entre eux (comme sur chatbot arena, avec des classements ELO) : on te présente deux modèles sans te dire lesquels et tu dis celui que tu préfères. Sauf que ça pose en gros les mêmes problèmes que l'évaluation à l'œil : ça repose sur de simples opinions. Ça t'apporte pas mal de choses, mais pas assez. Une quatrième façon consiste à prendre un modèle et à l'ouvrir en deux, comme si tu disséquais un cerveau, pour voir ce qui se passe. Ce sont des analyses en « boîte blanche » (le contraire d'une boîte noire : une boîte dont tu peux voir ce qu'il y a dedans) qui, soit sont très peu informatives pour certains modèles, soit sont trop lentes et impraticables. Sans compter que ni OpenAI ni Anthropic ne vont te donner accès à leur poule aux tokens d'or. Reste à leur faire passer des examens standardisés.
Le mot « benchmark » a de nombreuses acceptions, et on dirait qu'on parle d'une sorte de « banc d'essai » ou quelque chose du genre, mais ce n'est pas son origine. L'étymologie n'est pas toujours pertinente, mais dans ce cas elle peut aider à comprendre la question. Le mot anglais « benchmark » vient de la géodésie, la discipline qui s'occupe de mesurer la terre et qui sert de base aux topographes et aux géomètres. Les villes ont des altitudes différentes, ce qui oblige à tenir compte de l'élévation relative des différentes constructions, par exemple pour tracer des canalisations et ce genre de choses, afin de prendre en compte l'écoulement de l'eau dans une ville.
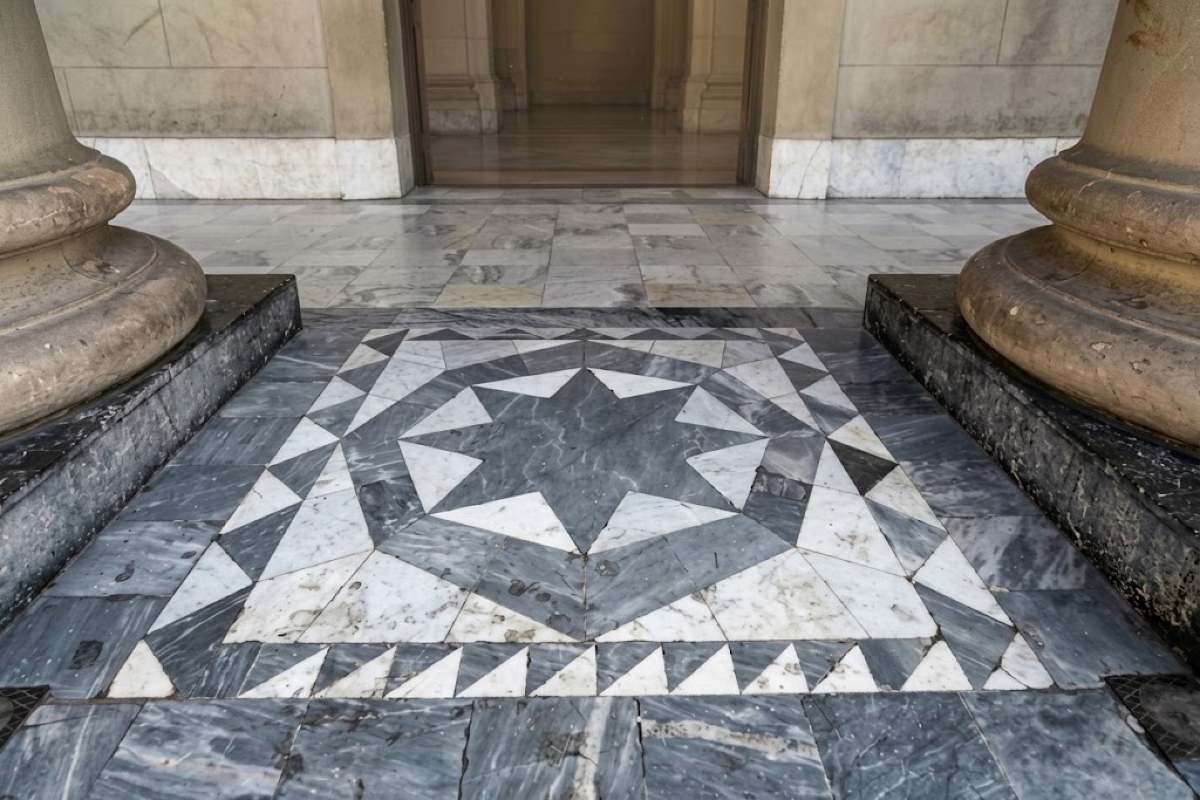
À cette fin, les autorités des villes modernes (et par modernes j'entends à partir du XVIIIe siècle, à peu près) se sont chargées de poser des « points fixes » géodésiques (c'est ainsi qu'on appelle en espagnol les benchmarks géodésiques) en différents endroits de la ville. Les villes ont un point fixe de référence, ou point zéro, qui dans la Ville autonome de Buenos Aires se trouve à l'entrée de la cathédrale. C'est une rose des vents. Tous les points fixes géodésiques de la capitale sont marqués à une altitude relative par rapport à ce point zéro.
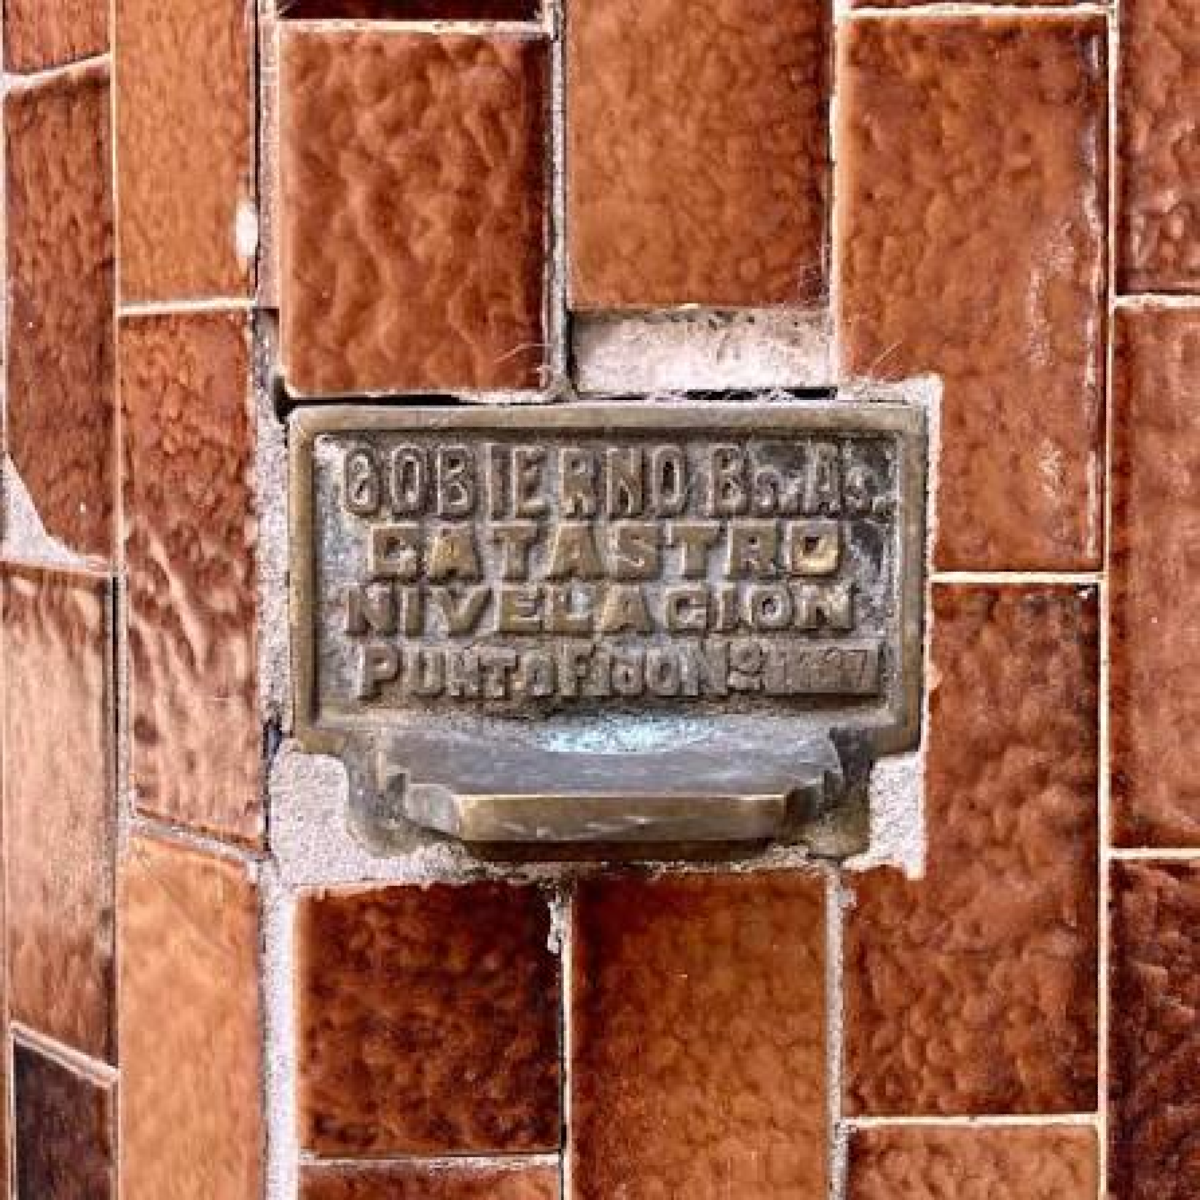
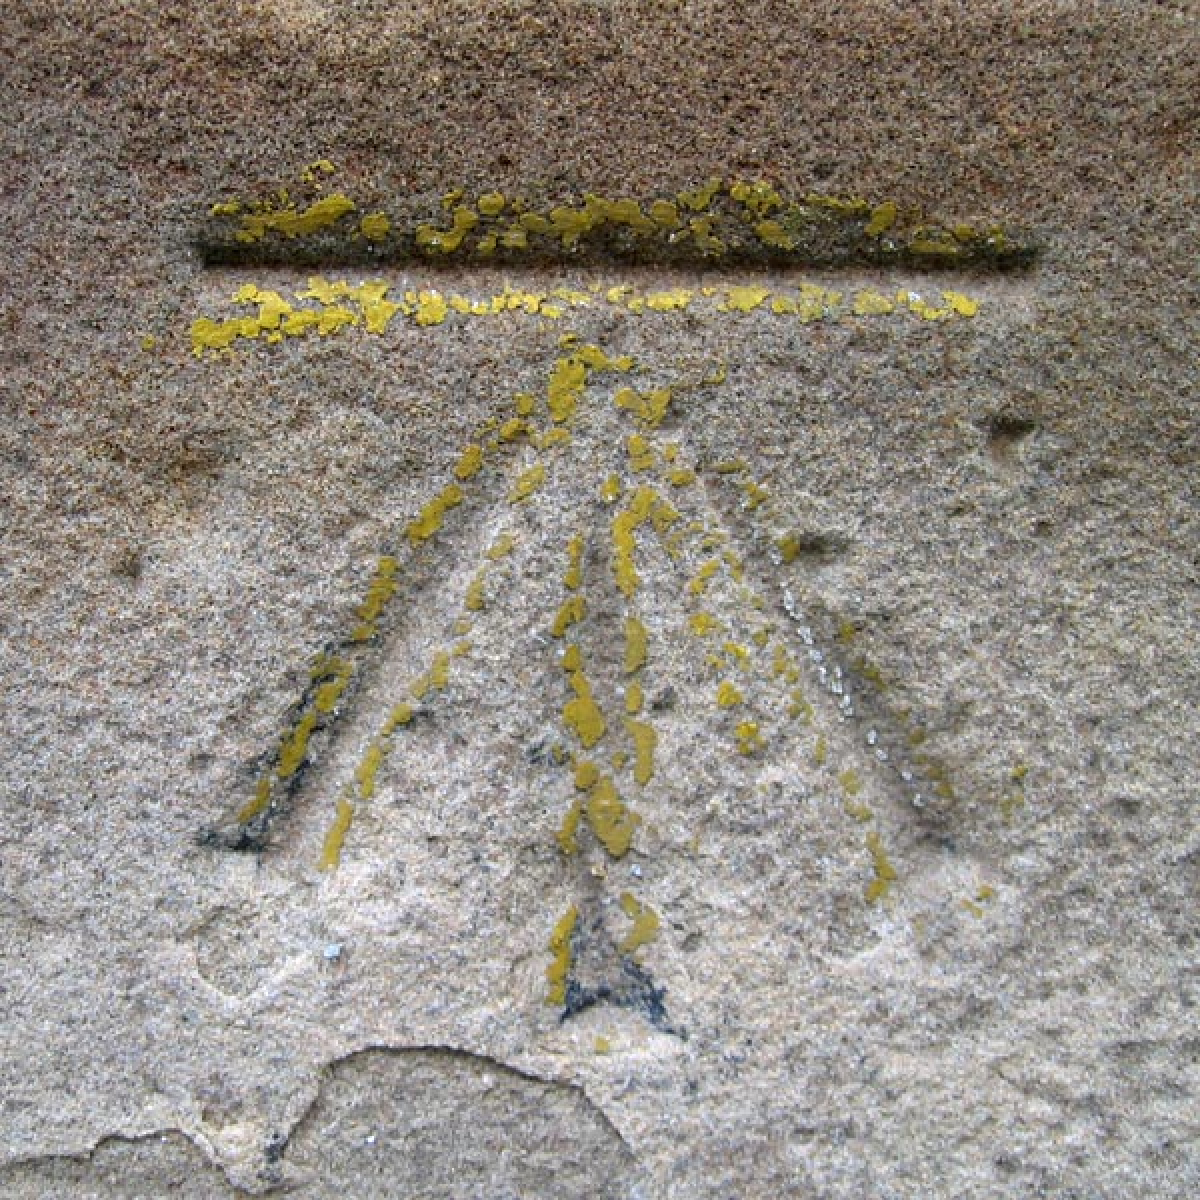
Le point fixe fondamental de la ville, celui de la cathédrale, ressemble à ça :
Mais il y a des points fixes dans tout le pays, posés par l'Instituto Geográfico Nacional (successeur de l'Instituto Geográfico Militar) :
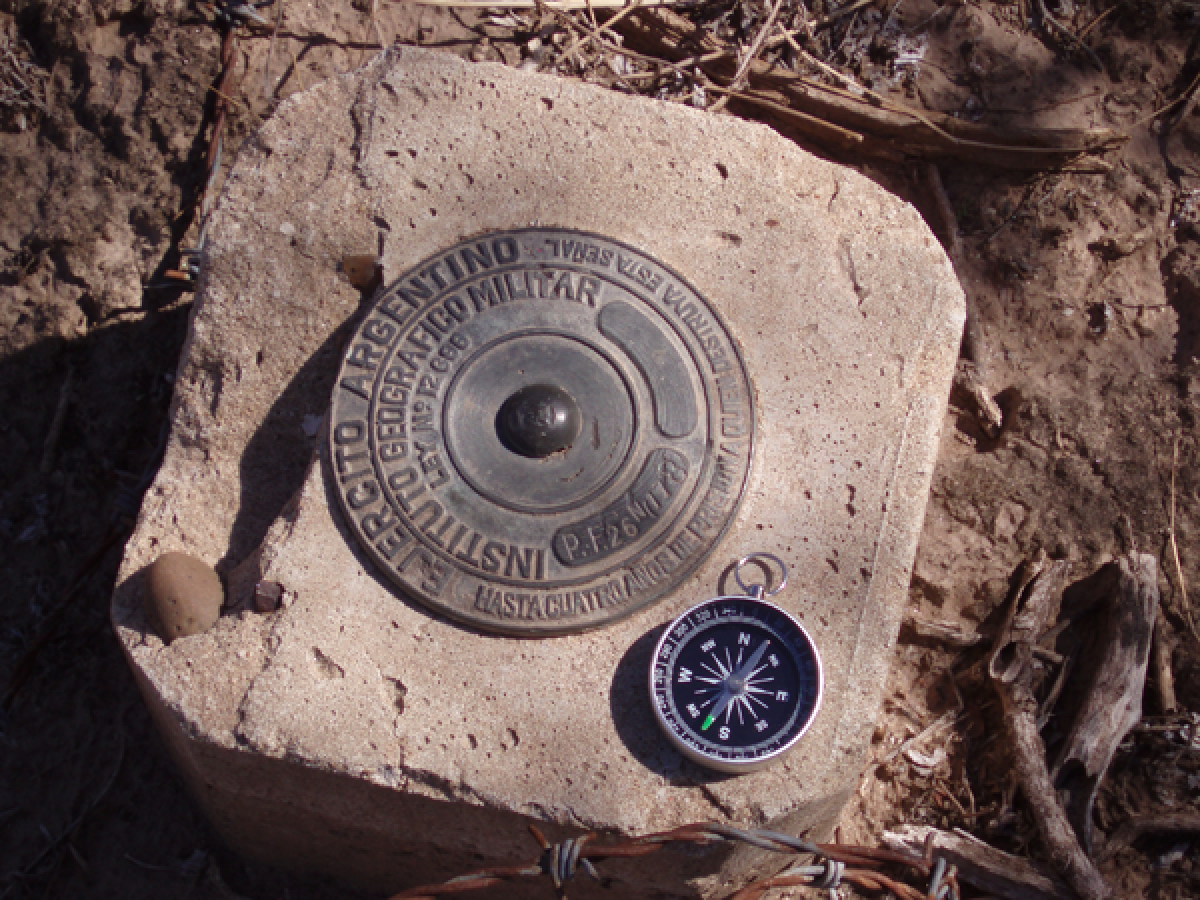
Cela permet aux géomètres, topographes, cartographes, architectes et ingénieurs civils de disposer de points de référence relatifs pour leurs travaux, cartographiés selon une altitude et une position géographique. Aujourd'hui, une bonne partie de tout ça se fait par GPS, mais aucun pays n'est assez idiot (pas encore, du moins) pour dépendre entièrement d'un système satellitaire pour une information aussi cruciale. Rien ne vaut un bout de fer encastré dans un mur et une pile de registres (low tech, high life, dirait Ruocco).
Par extrapolation de l'usage originel du « benchmarking » (tracer des marques [mark] horizontales dans la pierre ou le granit sur lesquelles poser un niveau et former un banc ou une assise [« bench »] pour une mire de nivellement), divers domaines utilisent le terme pour désigner un test de performance (relative) permettant de comparer plusieurs choses du même type. En informatique, nous les gamers nous en servons pour faire tourner des tests de performance de notre système sur certains jeux ou des tests de référence qui nous donnent une idée approximative de ce que vaut notre machine par rapport aux autres.
Une pratique courante dans les systèmes d'apprentissage automatique consiste à disposer d'un dataset (un ensemble de données) sur lequel entraîner le modèle, et à le diviser en 80 % pour l'entraînement et 20 % pour l'évaluation. Si le modèle entraîné sur les 80 %, sans jamais avoir vu l'ensemble de données d'évaluation, obtient de bonnes performances en prédisant les données de l'ensemble d'évaluation, on peut dire que le modèle a généralisé à partir des données vues dans l'ensemble d'entraînement et qu'en un certain sens il a « appris ». Sinon, non. Un modèle qui ne sait résoudre que des problèmes qu'il a déjà vus ne sert à rien.
En pratique, on peut se le représenter ainsi : dans l'ensemble de données d'entraînement, on a un tas de problèmes de géographie, d'algèbre ou d'analyse mathématique, une série de réponses possibles et la bonne réponse (ça peut être des problèmes de grammaire, ou de connaissance des cartes Magic). Dans l'ensemble de données d'évaluation, on a des problèmes qui n'apparaissaient pas à l'entraînement, et on ne montre pas la réponse au modèle : on la garde pour l'évaluer. On lui donne une série d'options (genre QCM, multiple choice) et on regarde s'il tombe juste. Le taux de bonnes réponses nous donne sa précision, ou accuracy, sur le dataset, qu'on peut prendre comme benchmark.
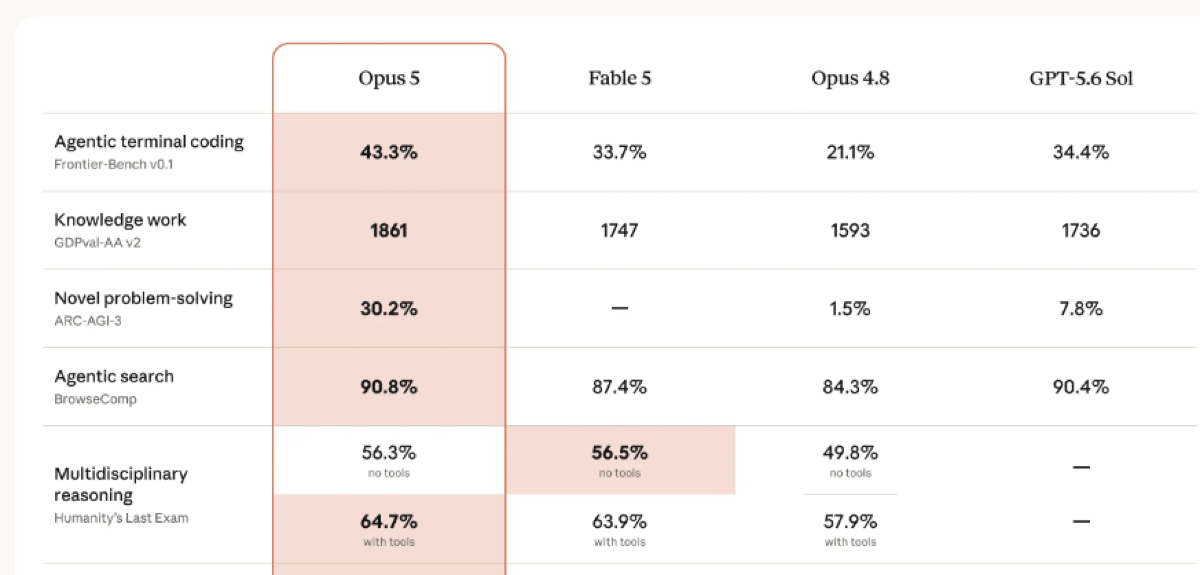
En ce sens, un ensemble de données d'évaluation (qu'il fasse partie d'un ensemble de données d'entraînement ou non) pouvant être administré à de nombreux modèles de langage joue le rôle de benchmark.
Bon, de même que le score de ta machine sur un benchmark graphique n'a pas d'importance en soi, mais seulement comme indice de ce que ta machine peut faire quand tu t'en sers pour jouer, faire du rendu vidéo ou quoi que tu veuilles faire (et qui n'est pas le benchmark), il se passe quelque chose de similaire avec les modèles de langage. Tu te fiches qu'un modèle de langage soit bon au benchmark parce que ça voudrait dire quelque chose en soi ; ce qui t'importe, c'est qu'il réussisse si le fait qu'il réussisse te dit quelque chose sur ce qu'il est capable de faire et qui n'est pas le benchmark.
Tu te fiches qu'un modèle de langage soit bon au benchmark parce que ça voudrait dire quelque chose en soi ; ce qui t'importe, c'est qu'il réussisse si le fait qu'il réussisse te dit quelque chose sur ce qu'il est capable de faire et qui n'est pas le benchmark.
C'est quelque chose de très proche de ce que nous faisons, nous les enseignants, quand nous faisons passer un examen. Les instruments d'évaluation n'ont pas d'importance en eux-mêmes. Beaucoup de lycéens (et beaucoup d'étudiants) agissent parfois avec l'idée (erronée) que les devoirs que leurs profs leur donnent, ou les dissertations qu'ils écrivent, sont une sorte de commande que le prof aurait intérêt à lire, comme si le prof allait y apprendre quelque chose. Comme si le devoir était une sorte de rapport qu'une entreprise commande à un cabinet de conseil. Je ne dis pas que nous, les enseignants, ne pouvons pas apprendre de nos élèves (ça nous arrive tout le temps), mais ce n'est pas la raison pour laquelle on les soumet à des évaluations.
L'un des rôles des évaluations est le diagnostic (il y en a d'autres, comme le rôle formatif : je veux que tu te creuses la tête pour que tu forges peu à peu la compétence visée) : je veux savoir où tu en es pour, à terme, avoir une certaine idée de comment tu t'en sortirais face à des problèmes similaires dans ta vie professionnelle (à l'université, par exemple). Autrement dit : les examens que passent les humains sont souvent des instruments pour avoir des raisons d'attribuer à une personne une compétence, entendue comme une disposition à résoudre des problèmes similaires. Une sorte de parent sophistiqué du fait de connaître quelqu'un, de voir qu'il nous ment plusieurs fois et de considérer que c'est une raison suffisante pour lui attribuer la propriété d'être menteur. Être catalogué comme menteur, c'est dangereux (comme dans l'histoire du garçon qui criait au loup) parce que les gens te traitent comme si tu allais continuer à mentir, et s'ils te traitent comme ça, ils ne te prennent plus au sérieux (c'est une forme particulière de mort sociale). En revanche, être catalogué comme avocat signifie que tu as remporté un round contre tous les profs de ton cursus (tel Ash face aux champions d'arène Pokémon), et qu'on suppose que tu pourras continuer à le faire à l'avenir.
Bref, de même que l'examen du permis de conduire n'est pas qu'une simple autorisation, mais une autorisation fondée sur l'attribution d'une compétence et de la responsabilité qui va avec (si tu es capable de bien conduire, tu es responsable quand tu conduis mal), il en va de même pour des compétences plus abstraites. Les capacités cognitives, par exemple. Les psychométriciens cherchent depuis longtemps à concevoir des façons d'évaluer des compétences plus abstraites, y compris la compétence des compétences, le Saint Graal des permis d'aptitude humains : l'intelligence.
Pour reprendre les mots du spécialiste en intelligence artificielle François Chollet (créateur du benchmark ARC-AGI), ta capacité à résoudre une tâche dit à quel point tu es habile, tandis que l'intelligence mesure à quel point tu es efficace (rapide, par exemple) pour acquérir de nouvelles capacités permettant de résoudre des tâches nouvelles. Autrement dit, quand on affirme que quelqu'un est intelligent, on ne dit pas qu'il est capable de faire quelque chose en particulier, seulement que, s'il en avait l'envie, l'occasion et le temps, il lui faudrait moins de temps ou d'efforts qu'à d'autres pour devenir adroit dans la compétence en question (c'est comme ça qu'on peut concilier le fait qu'il y ait autant de gens intelligents qui ne servent à rien, à leurs propres yeux ou à ceux des autres).
Ainsi, l'intelligence ne peut pas se mesurer directement, car une bonne part de tes compétences peut relever de ce que les psychométriciens appellent « l'intelligence cristallisée » (ou facteur g cristallisé Gc) par opposition à « l'intelligence fluide » (ou Gf). L'intelligence cristallisée n'intéresse pas tant que ça les psychologues spécialistes de la mesure des aptitudes cognitives, parce qu'on peut en savoir beaucoup sur un sujet et être un idiot (selon ces gens-là, ne me tapez pas dessus). La figure de l'« idiot savant » (génie idiot), c'est celle de quelqu'un qui retient des données mais se montre incapable de raisonner au-delà de ce qu'il a mémorisé. « Funes ou la mémoire » de Borges l'illustre peut-être mieux que personne.
Ces tests ne mesurent pas directement ton intelligence (ça ne semble pas possible), ils mesurent à quel résultat moyen par âge ton résultat ressemble. Si tu obtiens une note proche de celle d'un âge supérieur au tien, ça voudrait dire que tu es plus efficace que les gens de ton âge pour acquérir des aptitudes cognitives. Plus ton score correspond à la moyenne d'un âge élevé, plus le quotient grimpe : (ÂgeMental/Âge)*100 = QI.
Avertissement pour les jeunes de 20 ans qui se la pètent avec leur QI élevé : ça veut dire que vous obtenez la note moyenne des trentenaires, avec beaucoup de chance (quelqu'un de 18 ans avec un âge mental de 36 aurait 200 de QI, la limite mesurable ; 130 points, c'est avoir 18 ans et passer les tests de QI comme quelqu'un de 24...), ceux-là mêmes que vous chambrez. Avoir un QI élevé à 30 ans quand on est un homme, ça signifie seulement que tu peux angoisser parce que tu ne sais pas ce que tu fais de ta vie, te faire larguer, t'acheter une Harley Davidson (ou une PlayStation pour jouer à GTA VI si tu n'as pas d'héritage) avant tes 40 ans. Félicitations !
Seuls les morts ont vu la fin des guerres intergénérationnelles stupides. Le (discours sur le) QI (IQ en anglais) n'est qu'un champ de bataille de plus. Quoi qu'il en soit, rappelons que la seule raison pour laquelle avoir le même QI que Newton sonne bien (bonne chance), c'est que Newton a fait quelque chose d'intéressant de sa vie. Moi, je me concentrerais là-dessus.
On peut poser la même question à propos des LLM : sont-ils intelligents ou ont-ils mémorisé des données ? Ted Chiang (le très célèbre écrivain de science-fiction), par exemple, affirme qu'ils ne sont qu'une forme de compression de données (comme un .zip ou un .rar). Une compression avec perte (lossy compression) : il a employé l'image selon laquelle les LLM seraient un .jpeg flou d'internet. Alors, comment évaluer des modèles de langage qui se sont enfilé un smoothie de toutes les données écrites numérisées par l'humanité, pour pouvoir affirmer qu'ils ne font pas que régurgiter et qu'ils peuvent atteindre une véritable compréhension ? C'est la question à mille milliards de dollars, et le benchmark, c'est nous.
L'intelligence artificielle générale est le pendant de notre intelligence générale naturelle. Il faut donc réfléchir à la façon dont nous pouvons affirmer que nous sommes intelligents, à ce dont nous sommes capables, à ce qui nous fait vraiment nous attribuer de l'intelligence les uns aux autres, pour tenter d'extrapoler ces idées aux modèles de langage. Si nous parvenons à concevoir des évaluations qui prédisent de bonnes performances générales dans n'importe quelle tâche cognitive, nous aurons des raisons de croire qu'ils sont intelligents. Ça implique de concevoir un construit théorique appelé « intelligence générale », un modèle de ce que nous pensons être l'intelligence, et de monter des tâches (des examens) à utiliser comme benchmarks pour les modèles de langage, qui, si les LLM les réussissaient, nous donneraient de vraies raisons de dire qu'ils possèdent ce que nous supposons évaluer (le construit théorique). Le genre de choses devant lesquelles on se dirait « s'il est capable de résoudre ça, je lui confie mes finances » (ou mes armes nucléaires, si tu es les États-Unis ou la Chine).
Comment évaluer des modèles de langage qui se sont enfilé un smoothie de toutes les données écrites numérisées par l'humanité, pour pouvoir affirmer qu'ils ne font pas que régurgiter ? C'est la question à mille milliards de dollars, et le benchmark, c'est nous.
Mais ce n'est pas si simple. Aujourd'hui, la conception de modèles de langage a besoin de benchmarks pour savoir quelles pistes de recherche suivre. Inventer de nouvelles architectures de modèles de langage n'a pas grand-chose à quoi se raccrocher si l'on ne peut pas savoir si ces nouvelles architectures sont meilleures que les précédentes. Qu'elles aient l'air meilleures ne suffit pas. Pire encore, on peut parier que chaque benchmark rendu public finira dans les données d'entraînement des modèles suivants, si bien que l'information que nous apporte sa résolution est limitée : une fois un benchmark publié (l'idée est qu'il soit reproductible et équitable, et une façon d'y parvenir est qu'il soit public), Anthropic ou les gens d'Alibaba peuvent entraîner le modèle sur le benchmark, en s'assurant que leur modèle excelle au benchmark sans forcément être bon dans l'aptitude que le benchmark était censé mesurer.
L'industrie et le public ont besoin de meilleures évaluations, mais c'est une tâche ingrate, coûteuse et difficile, croyez-moi. Personne n'aime les profs quand on fait passer des examens, et ce n'est pas très différent pour les évaluations de modèles de langage. Il y a beaucoup plus d'argent à concevoir ces machines qu'à les évaluer. Et ce n'est que le problème lié à quelque chose dont nous avons une référence : nos propres capacités, même si nous ne savons pas bien les mesurer, ni chez les humains ni chez les machines. La grande question, c'est : à quoi ressemblerait le (ou les) benchmark du Dieu-dans-la-machine de la Silicon Valley ? Comment saurions-nous que nous avons atteint une superintelligence artificielle ? Peut-être qu'il se passerait ce que laisse entrevoir Gibson dans certains de ses romans, ou le film Her de Spike Jonze : nous ne nous en rendrions pas compte. Elles nous dépasseraient sans un regard, et nous aurions perdu la maîtrise cognitive du monde sans le savoir. Ou peut-être que la question n'est pas si bonne.
Y a cada colaborador se le paga por su trabajo. Las dos cosas dependen de los suscriptores.