Benchmarking: La carrera por evaluar la inteligencia artificial
¿Cómo saber si una IA "reflexiona" o solo regurgita datos? La ciencia de evaluar mentes digitales sin caer en el engaño.

¿Cómo saber si una IA "reflexiona" o solo regurgita datos? La ciencia de evaluar mentes digitales sin caer en el engaño.

Dame un punto fijo y moveré el mundo. - Arquímedes
Existe una carrera armamentística en el corazón del desarrollo de inteligencias artificiales en general, pero me me voy a enfocar en las aplicadas al lenguaje en particular. El desarrollo de un sistema de IA busca alcanzar una serie de capacidades, en principio cognitivas, humanas o útiles a humanos. Ya sea redacción de texto, comprensión, traducción, resumen, ser educados, ser justos, producir informes de inteligencia, declarar que siempre estuvimos en guerra con Eurasia, engañar, carpetear opositores, ganar guerras termonucleares, etc. Para cualquiera de esas tareas, debe existir una manera de evaluar si el sistema lo hace bien o mal, y, en particular, cómo se compara con otros sistemas diseñados con el mismo objetivo.
Este es un problema que afecta a quienes diseñan (o cultivan) los modelos, como a quienes quisieran contratarlos o usarlos. Quienes crean sistemas de inteligencia artificial necesitan objetivos medibles a los que apuntar; quienes quieren contratar modelos o considerar usarlos quieren saber cuál es el mejor. ¿Pero cómo se hace? Bueno, una forma es hacerlo por vibes, que es la variante sofisticada de lo que hace todo el mundo al usar un modelo de lenguaje. Lo usás, le das un problema que pensás que no va a poder solucionar, lo soluciona, se te cae la mandíbula y decís "fah, no sabés lo que es". Pero como muchos nos hemos dado cuenta, eso puede llegar a ser suerte, o justamente el tipo de problemas para los que el modelo fue entrenado, y que haya hecho bien eso no te garantiza que pueda hacer bien otras cosas.
Quienes crean sistemas de inteligencia artificial necesitan objetivos medibles a los que apuntar; quienes quieren contratar modelos o considerar usarlos quieren saber cuál es el mejor. ¿Pero cómo se hace?
Una forma más sofisticada de evaluar el rendimiento de modelos de lenguaje es poner a expertos a evaluarlos directamente sobre sus habilidades/conocimientos. Esto funciona un poco mejor, pero es mucho más caro, lento y todavía falible. Una forma más consiste en hacer competir a los modelos con vibes, entre sí (como lo que hacen en chatbot arena, con ELO rankings): te dan dos modelos sin decirte cuáles son y decís cuál te gusta más. Sin embargo, eso tiene básicamente los mismos problemas que evaluar a ojo: descansa en meras opiniones. Te da bastante, pero no suficiente. Una cuarta forma es tener un modelo y abrirlo al medio, como si diseccionaras un cerebro, y ver qué pasa. Estos son análisis de "caja blanca" (lo contrario a una caja negra, una caja que podés mirar qué tiene adentro) que, o bien son escasamente informativos para ciertos modelos, o bien demasiado lentos e impracticables. Sin contar que ni OpenAI ni Anthropic te van a dar acceso a su gallina de los tokens de oro. Queda tomarles exámenes estandarizados.
La palabra "benchmark" tiene muchas acepciones, y suena a que hablamos de algún tipo de "banco de pruebas" o algo por el estilo, pero no es ese su origen. La etimología no siempre es relevante, pero en este caso puede ayudar a entender la cuestión. La palabra inglesa "benchmark" viene de la geodesia, la disciplina que se encarga de hacer mediciones de la tierra y que es insumo de topógrafos y agrimensores. Las ciudades tienen diferentes alturas que requieren tener en cuenta la elevación relativa de diferentes construcciones, por ejemplo para hacer trazas de cañerías y cosas por el estilo, para tener en cuenta la caída del agua en una ciudad.
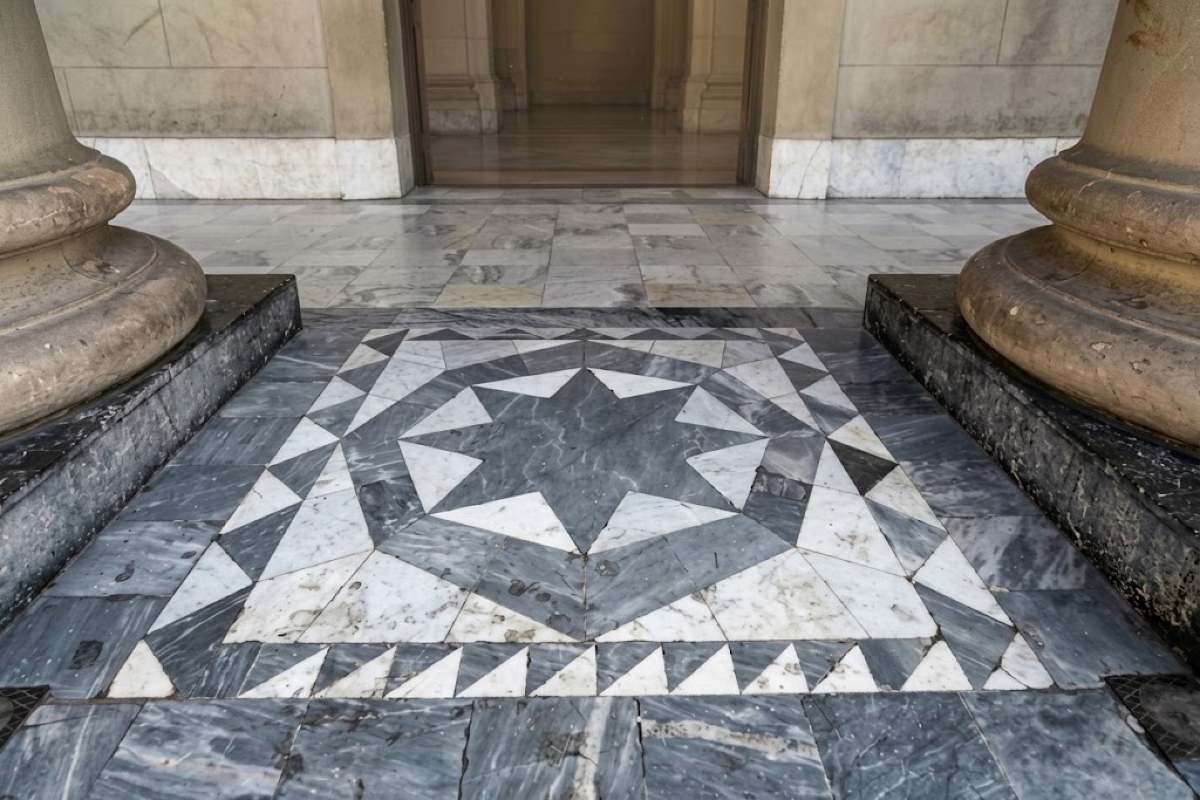
Para ese fin las autoridades en las ciudades modernas (y con modernas me refiero al siglo XVIII para acá, aproximadamente) se encargaron de marcar "puntos fijos" geodésicos (como les decimos a los benchmarks geodésicos en castellano) en diferentes partes de la ciudad. Las ciudades tienen un punto fijo de referencia, o punto cero, que en la Ciudad Autónoma de Buenos Aires se encuentra a la entrada de la Catedral. Es una rosa de los vientos. Todos los puntos fijos geodésicos de la capital están marcados en una altura relativa con respecto a ese punto cero.
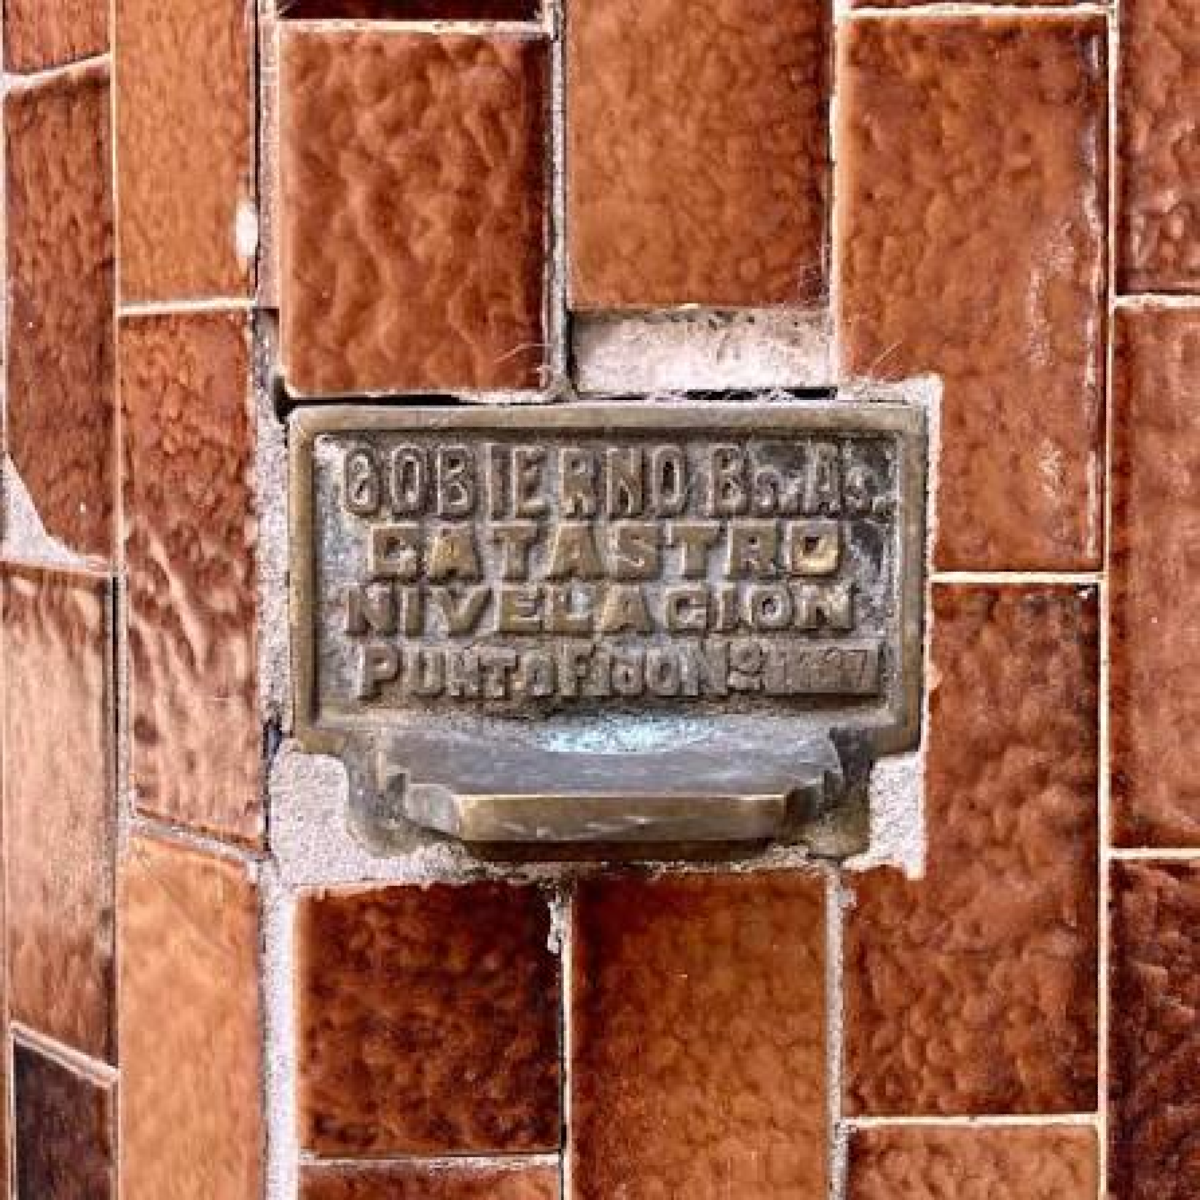
El punto fijo fundamental de la ciudad, el que está en la Catedral, se ve así:
Pero hay puntos fijos en todo el país que pone el Instituto Geográfico Nacional (sucesor del Instituto Geográfico Militar):
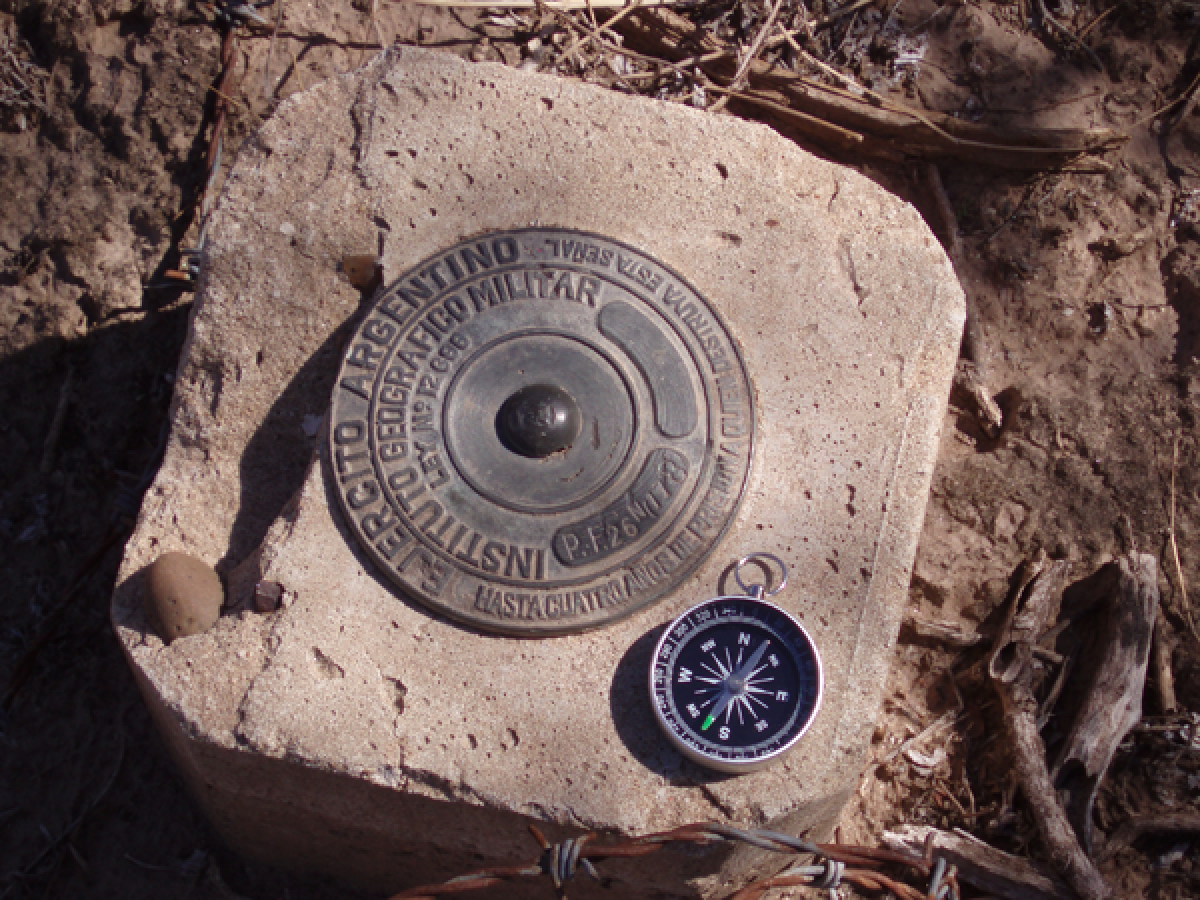
Esto permite a agrimensores, topógrafos, cartógrafos, arquitectos e ingenieros civiles tener puntos relativos de referencia para sus trabajos que estén mapeados a una altura y posición geográfica. Hoy en día mucho de esto se hace con GPS, pero ningún país es tan idiota (todavía, al menos) como para depender enteramente de un sistema satelital para esta información crucial. Nada le gana a un pedazo de hierro incrustado en una pared y muchas planillas (low tech, high life diría Ruocco).
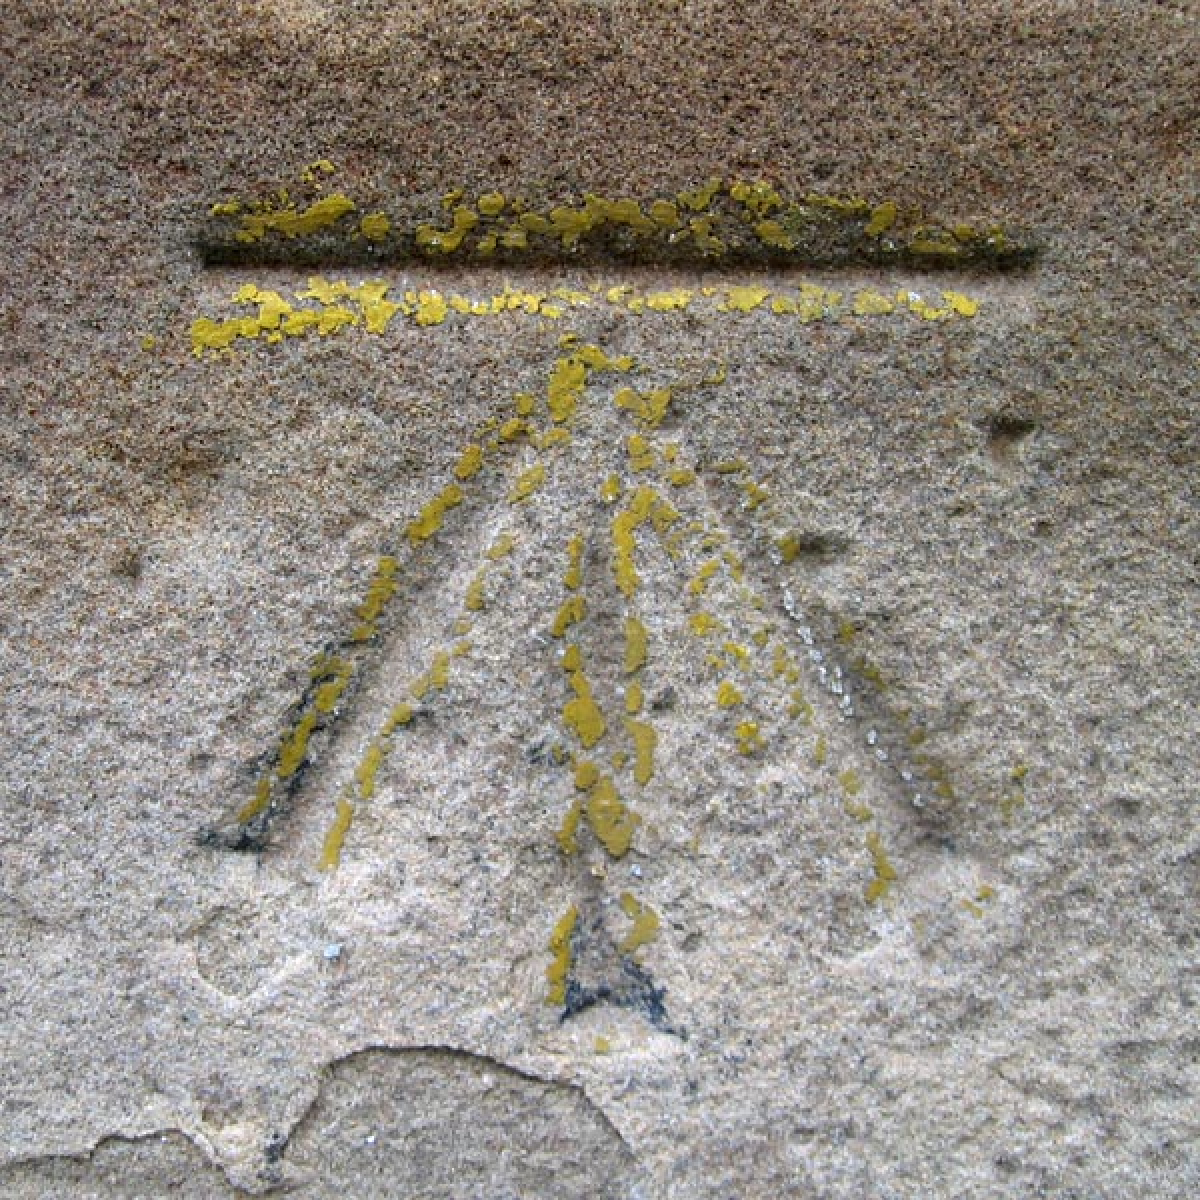
Como una extrapolación del uso original del "benchmarking" (hacer marcas [mark] horizontales en piedra o granito sobre las cuales apoyar un nivel y formar un banco o asiento ["bench"] para una vara de nivelación), en diferentes áreas se utilizan el término para referirse a una prueba de rendimiento (relativo) sobre la cual comparar varias cosas del mismo tipo. En computación, los gamers los usamos para correr pruebas de rendimiento de nuestro sistema en ciertos juegos o test de referencia que nos dan una indicación aproximada de qué tan buena es nuestra máquina con respecto a otras.
Una práctica usual en sistemas de aprendizaje automático es tener un dataset (un conjunto de datos) sobre el cual entrenar al modelo y dividirlo en un 80% de entrenamiento y un 20% de evaluación. Si el modelo entrenado en el 80%, sin nunca ver el conjunto de datos de evaluación, tiene un rendimiento alto al predecir los datos del conjunto de evaluación, se puede decir que el modelo generalizó a partir de los datos vistos en el conjunto de datos de entrenamiento y en algún sentido "aprendió". De otra manera no. Un modelo que sólo pueda resolver problemas que ya vio no sirve para nada.
En la práctica podemos pensarlo así: En el conjunto de datos de entrenamiento tenemos un montón de problemas de geografía, álgebra o análisis matemático, una serie de posibles respuestas y la respuesta correcta (pueden ser problemas gramaticales, o de conocimiento de cartas Magic). En el conjunto de datos de evaluación tenemos problemas que no aparecieron en entrenamiento y no le mostramos la respuesta al modelo, nos la guardamos para evaluarlo. Le damos una serie de opciones (tipo examen multiple choice) y vemos si le pega. La razón de aciertos nos da su precisión o accuracy en el dataset que podemos tomar como un benchmark.
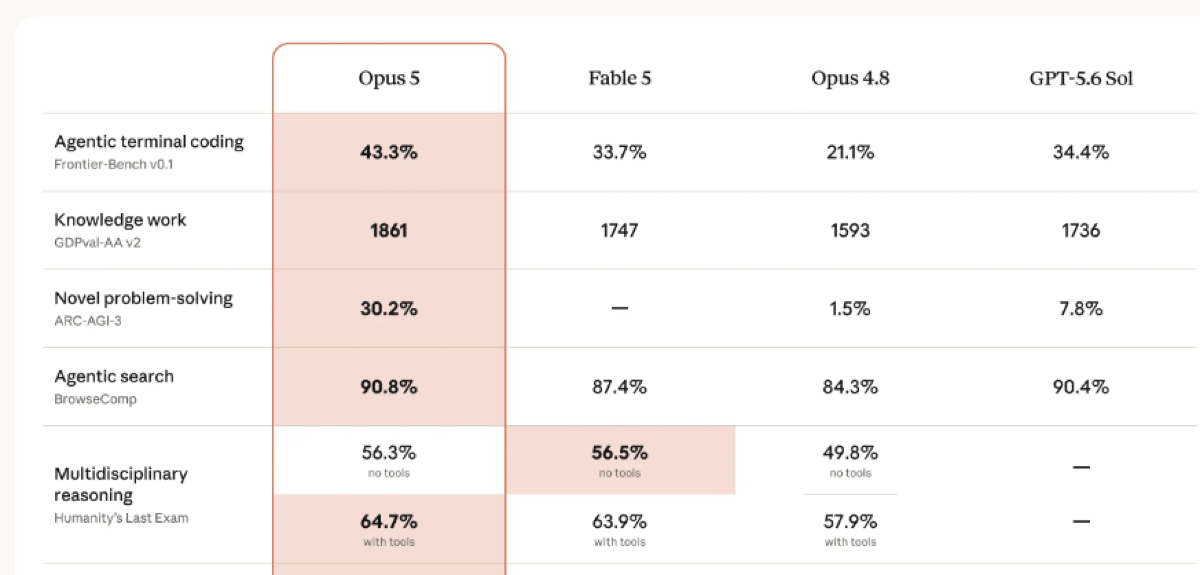
En este sentido, un conjunto de datos de evaluación (ya sea que formen parte de un conjunto de datos de entrenamiento o no) que pueda ser administrado a muchos modelos de lenguaje cumple el rol de un benchmark.
Ahora, así como que tu máquina tenga determinado puntaje en un benchmark gráfico no es importante en sí mismo sino como indicio de lo que tu máquina puede hacer cuando la uses para jugar, o renderizar videos, o lo que sea que quieras hacer (que no es el benchmark). Con los modelos de lenguaje te pasa algo parecido. No te importa que un modelo de lenguaje sea bueno en el benchmark porque signifique algo en sí mismo, te importa que le vaya bien si el hecho de que le vaya bien te dice algo sobre lo que puede hacer que no es el benchmark.
No te importa que un modelo de lenguaje sea bueno en el benchmark porque signifique algo en sí mismo, te importa que le vaya bien si el hecho de que le vaya bien te dice algo sobre lo que puede hacer que no es el benchmark.
Esto es algo muy parecido a lo que hacemos los docentes al tomar un examen. Los instrumentos de evaluación no importan en sí mismos. Muchos alumnos de secundario (y muchos universitarios) a veces actúan bajo la (errónea) idea de que los trabajos prácticos que sus docentes les encargan, o los ensayos que escriben, son algún tipo de encargo que el docente va a ganar algo en leer, como si el docente fuera a aprender algo. Como si el trabajo práctico fuera algún tipo de informe que una empresa le encarga a una consultora. No quiero decir que los docentes no podamos aprender de nuestros alumnos (lo hacemos todo el tiempo), pero no es la razón para someterlos a evaluaciones.
Uno de los roles de las evaluaciones es el diagnóstico (existen otros, como un rol formativo: quiero que te rompas la cabeza para que vayas forjando la habilidad objetivo involucrada): quiero saber cómo venís para eventualmente tener cierta idea de cómo te iría al resolver problemas parecidos en tu vida profesional (en el nivel universitario, por ejemplo). Es decir: los exámenes a humanos, muchas veces, son instrumentos para tener razones para atribuirle a una persona una competencia entendida como una disposición a resolver problemas parecidos. Una especie de pariente sofisticado de conocer a alguien, ver que nos miente varias veces y considerarlo razón suficiente para atribuirle la propiedad de ser mentiroso. Que te cataloguen de mentiroso es un peligro (como en el cuento del pastorcito y el lobo) porque la gente te trata como si fueras a seguir mintiendo, y, si te tratan así, no te toman más en serio (es una especie particular de muerte social). En cambio, que te cataloguen de abogado significa que le ganaste un round a todos los profesores de la carrera (cual Ash a los maestros Pokémon), y se supone que vas a poder seguir haciéndolo en el futuro.
Bueno, así como el examen de conducir no es meramente un permiso, sino un permiso basado en una atribución de competencia y responsabilidad aparejada (si sos capaz de manejar bien, sos responsable por manejar mal), lo mismo sucede con competencias más abstractas. Las capacidades cognitivas por ejemplo. Los psicometristas vienen hace largo rato tratando de diseñar formas de evaluar competencias más abstractas, incluyendo la competencia de competencias, el Santo Grial de los permisos de habilidad humanos: la inteligencia.
En las palabras del especialista en Inteligencia Artificial François Chollet (creador del benchmark ARC-AGI), tu capacidad de resolución de una tarea habla de que tan habilidoso sos, y la inteligencia mide qué tan eficiente (rápido, por caso) sos en adquirir nuevas capacidades para resolver tareas nuevas. Es decir, cuando afirmamos que alguien es inteligente no estamos diciendo que sea capaz de hacer algo en particular, sólo que, si tuviera ganas, oportunidad y tiempo le costaría menos tiempo o esfuerzo que a otras personas volverse diestro en la habilidad en cuestión (así es como podemos compatibilizar que haya tanta gente inteligente que no sirve para nada, a los ojos de ellos mismos u otros).
Así, la inteligencia no se puede medir directamente, porque mucha de tu competencia puede ser lo que los psicometristas llaman "inteligencia cristalizada" (o factor g cristalizado Gc) versus "inteligencia fluida" (o Gf). La inteligencia cristalizada no le interesa tanto a los psicólogos especialistas en medir habilidades cognitivas porque es posible saber mucho sobre algo y ser un idiota (según esta gente, no me culpen a mí). La figura del "idiot savant" (genio idiota) es la de la figura que recuerda datos pero es incapaz de razonar más allá de los datos memorizados. Quizás "Funes el memorioso" de Borges ilustre esto mejor que nadie.
Estos test no están midiendo directamente tu inteligencia (no parece ser posible tal cosa), están midiendo a qué resultado promedio por edad se parece tu resultado. Si te sacás una nota parecida a una edad mayor que la que tenés, significaría que sos más eficiente en alcanzar destrezas cognitivas que la gente de tu edad. Mientras coincida con un puntaje promedio de una edad cada vez mayor, más va a ser el cociente: (EdadMental/Edad)*100 = CI.
Nota de advertencia para los jóvenes de 20 que se la den de tener un CI alto: significa que se sacan una nota promedio de gente de 30 años, con mucha suerte (alguien de 18 con edad mental de 36 tendría 200 puntos de CI, el límite medible, 130 puntos es tener 18 y rendir exámenes de CI como alguien de 24...), los mismos que bardean. Tener un CI alto a los 30 siendo varón sólo significa que podés angustiarte por no saber qué estás haciendo de tu vida, que te deje tu pareja, comprarte una Harley Davidson (o una Playstation para jugar al GTA VI si no sos heredero) antes de llegar a los 40, ¡felicitaciones!
Sólo los muertos han visto el fin de las guerras intergeneracionales estúpidas. El (discurso sobre el) CI (IQ en inglés) es sólo otro de sus campos de batalla. En cualquier caso, recordemos que la única razón por la que suena lindo tener el mismo cociente intelectual que Newton (suerte con eso) es porque Newton hizo algo interesante de su vida. Yo me enfocaría en eso.
La misma pregunta se puede hacer sobre los LLM: ¿son inteligentes o memorizaron datos? Ted Chiang (el famosísimo escritor de ciencia ficción), por ejemplo, dice que son meramente un tipo de compresión de datos (como un .zip o .rar). Un tipo de compresión con pérdida (lossy compression): usó la imagen de que los LLM son un .jpeg borroso de internet. Entonces, ¿cómo evaluamos a modelos de lenguaje que se tomaron un licuado de todos los datos escritos digitalizados por la humanidad para sostener que no están meramente regurgitando y que pueden alcanzar verdadera comprensión? Esa es la pregunta de los mil trillones de dólares, y el benchmark somos nosotros.
La Inteligencia General Artificial es el correlato de nuestra inteligencia general natural. Así que hay que pensar en cómo podemos sostener que somos inteligentes, qué somos capaces de hacer, qué hace que nos atribuyamos inteligencia unos a otros realmente para intentar extrapolar esas ideas a los modelos de lenguaje. Si podemos diseñar evaluaciones que predigan buen desempeño general en cualquier tarea cognitiva, vamos a tener razones para creer que son inteligentes. Eso significa que hay que diseñar un constructo teórico llamado "inteligencia general", un modelo de lo que pensamos que es la inteligencia, y armar tareas (exámenes) para usar de benchmarks en modelos de lenguaje que si los LLM los resolvieran, nos dieran verdaderas razones para decir que tienen eso que suponemos que estamos evaluando (el constructo teórico). El tipo de cosas que diríamos "si puede resolver eso, le doy mis finanzas" (o mis armas nucleares, si sos EE.UU. o China).
¿Cómo evaluamos a modelos de lenguaje que se tomaron un licuado de todos los datos escritos digitalizados por la humanidad para sostener que no están meramente regurgitando? Esa es la pregunta de los mil trillones de dólares, y el benchmark somos nosotros.
Pero no es tan fácil. Hoy en día, el diseño de modelos de lenguaje necesita benchmarks para saber qué direcciones de investigación perseguir. Inventar nuevas arquitecturas de modelos de lenguaje tiene poco de qué agarrarse si no podemos saber si esas nuevas arquitecturas son mejores que las anteriores. Que parezcan mejores no alcanza. Peor aún, cada benchmark que se hace público podemos descontar que va a aparecer en los datos de entrenamiento de modelos siguientes, por lo que la información que nos da su resolución es limitada: luego de que publicamos un benchmark (la idea es que sea repetible y justo, y una manera de hacer eso es que sea público) Anthropic o la gente de Alibaba pueden entrenar al modelo sobre el benchmark, asegurándose de que su modelo sea excelente en el benchmark sin necesariamente ser bueno en la habilidad que el benchmark fue pensado para medir.
La industria y el público necesitan mejores evaluaciones, pero es una tarea ingrata, cara y difícil, créanme. Nadie quiere a los docentes cuando tomamos exámenes, y no pasa algo tan distinto con las evaluaciones de modelos de lenguaje. Hay mucho más dinero en diseñar estas máquinas que en evaluarlas. Y ese es sólo el problema ligado a algo de lo que tenemos referencia: nuestras capacidades, así no sepamos medirlas bien ni en personas ni en máquinas. La gran pregunta es, ¿cómo se vería el (o los) benchmark para el Dios-en-la-máquina de Silicon Valley? ¿Cómo sabríamos que alcanzamos una superinteligencia artificial? Quizás pasaría lo que deja entrever Gibson en algunas de sus novelas o en la película Her de Spike Jonze: no nos daríamos cuenta. Nos pasarían de largo, y habríamos perdido el dominio cognitivo del mundo sin saberlo. O quizás la pregunta no sea tan buena.
Y a cada colaborador se le paga por su trabajo. Las dos cosas dependen de los suscriptores.